文章来源:https://newsletter.semianalysis.com/p/co-packaged-optics-cpo-book-scaling
◆ 目录
1. 共封装光学(CPO)总拥有成本(TCO)分析
2. 共封装光学(CPO)简介与实现方案
3. 共封装光学(CPO)的市场化落地与部署挑战
4. 当下与未来的共封装光学(CPO)产品
共封装光学(Co-Packaged Optics, CPO)长期以来一直被寄予变革数据中心互联的厚望,但该技术的市场化进程耗时良久,直至2025年才出现可实际部署的成熟产品。在此期间,可插拔光模块凭借其相对成本效益、部署熟悉度及基于标准的互操作性,始终紧跟网络需求,仍是行业默认选择。
然而,AI工作负载带来的海量网络需求,正彻底改变这一格局。AI网络带宽的发展路线表明,互联速度、传输距离、密度及可靠性要求即将突破光模块的能力上限。CPO虽能为scale-out网络带来一定收益并提供更多选择,但它将成为scale-up网络的核心支撑——在本十年后半段及未来,CPO将是推动纵向扩展网络带宽增长的主要动力。
当前基于铜缆的scale up解决方案(如NVLink),每块GPU可提供高达7.2太比特/秒的带宽,下一代Rubin架构更是将达到14.4太比特/秒。但铜缆链路的传输距离最多仅为2米,这意味着纵向扩展域的规模最多局限于1-2个机架,且通过铜缆扩展带宽的难度正日益增加。
Rubin架构中,英伟达将通过双向SerDes实现铜缆单通道带宽翻倍,但依靠研发更快的serdes来提升铜缆带宽,是一条极具挑战性、进展缓慢的道路。而CPO不仅能提供相当或更优的带宽密度,还能提供更多带宽扩展路径,同时支持更大规模的scale up域。
理解CPO发展动力的关键,在于审视使用光模块进行光通信时存在的诸多低效问题与权衡取舍。光模块虽能实现更长的链路传输,但网络交换机或计算托盘面板上的光模块插槽,通常距离加速器(XPU)或交换机专用集成电路(ASIC)有15-30cm。这意味着信号需先通过长距离LR SerDes以电信号形式传输这15-30cm,再由模块内的DSP恢复后,才能转换为光信号。而CPO将光引擎直接部署在XPU或交换机ASIC旁,无需DSP,且可使用低功耗serdes将数据从XPU传输至光引擎,与DSP收发器相比,数据传输能耗可降低50%以上,部分方案甚至有望降低80%。
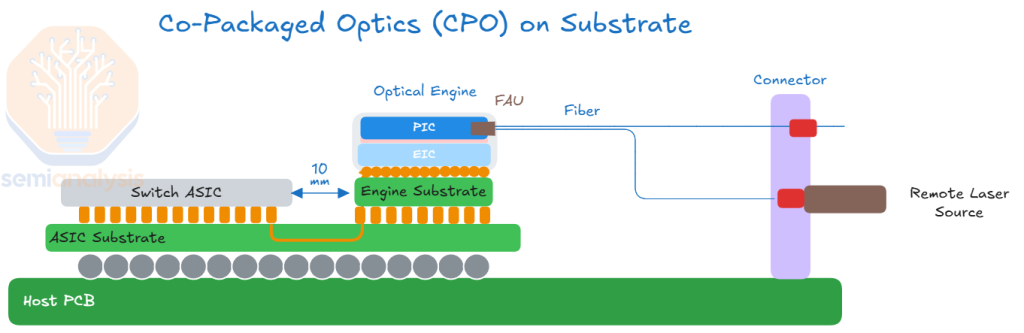
共封装光学(CPO)基板部署示意图
尽管英伟达和博通(Broadcom)等企业的scale out CPO解决方案备受关注,且受到终端客户的密切关注,但大型超大规模数据中心运营商已开始规划scale up CPO战略,并与供应商达成合作。例如,Celestial AI预计到2028日历年年底,营收年化率将达到10亿美元——Semianalysis认为这一目标主要依靠为亚马逊Trainium 4提供的scale upCPO解决方案实现。
如今,专注于CPO的企业已远超论文发表、试点项目和技术演示阶段,正围绕光端口架构等关键产品决策展开布局,以解决大规模生产问题。对于scale up CPO而言,核心问题已不再是“是否需要”或“为何需要”,而是“何时落地”与“如何落地”——如何实现量产,以及激光制造商等关键组件供应链企业何时能提升足够产能。
本文将深入探讨CPO的优势与挑战、架构原理、当前及未来产品、相关企业及供应链,为从业者、行业分析师、投资者及所有关注互联技术的人士提供参考指南。
1. 共封装光学(CPO)总拥有成本(TCO)分析
2025年英伟达GTC大会上,最受期待的议题之一便是黄仁勋宣布推出首款支持CPO的scale out网络交换机。值得注意的是,在scale up领域,英伟达仍坚持使用铜缆,甚至计划将这一策略延续至2027-2028年。
Semianalysis从总拥有成本(TCO)角度切入,分析这些新型CPO交换机的成本与功耗优势——尽管这些优势尚未足以让客户彻底转向全新部署模式,因此预计首批scale out CPO交换机的采用率将较为有限,具体原因如下:
◆ 典型AI集群网络配置与TCO
典型AI集群包含三类核心网络结构:后端网络、前端网络和带外管理网络。其中,后端网络是利用率最高、技术要求最严苛的部分,用于GPU间的scale out通信,通过协同操作实现训练和推理的并行化,通常采用InfiniBand或以太网协议。
由于其高要求特性,后端网络占据了网络总成本和功耗的主导份额:在采用英伟达X800-Q3400后端交换机、基于InfiniBand的三层GB300 NVL72集群中,后端网络占网络成本的85%、网络功耗的86%。CPO交换机及网络解决方案可同时应用于后端和前端网络,但目前部署重点仍集中在后端网络。
从整体来看,网络成本是AI集群总成本中仅次于AI服务器的第二大组成部分。在采用三层InfiniBand网络的GB300 NVL72集群中,网络成本占比15%;若采用四层网络,占比将升至18%。光模块是网络成本的重要组成部分——在使用相对昂贵的英伟达LinkX收发器的三层网络中,光模块占网络成本的60%,且消耗45%的网络总功耗。
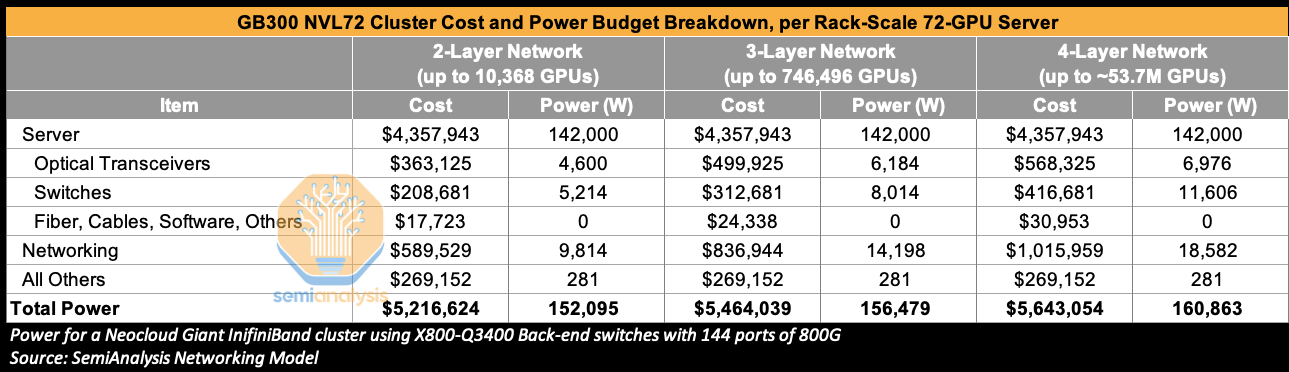
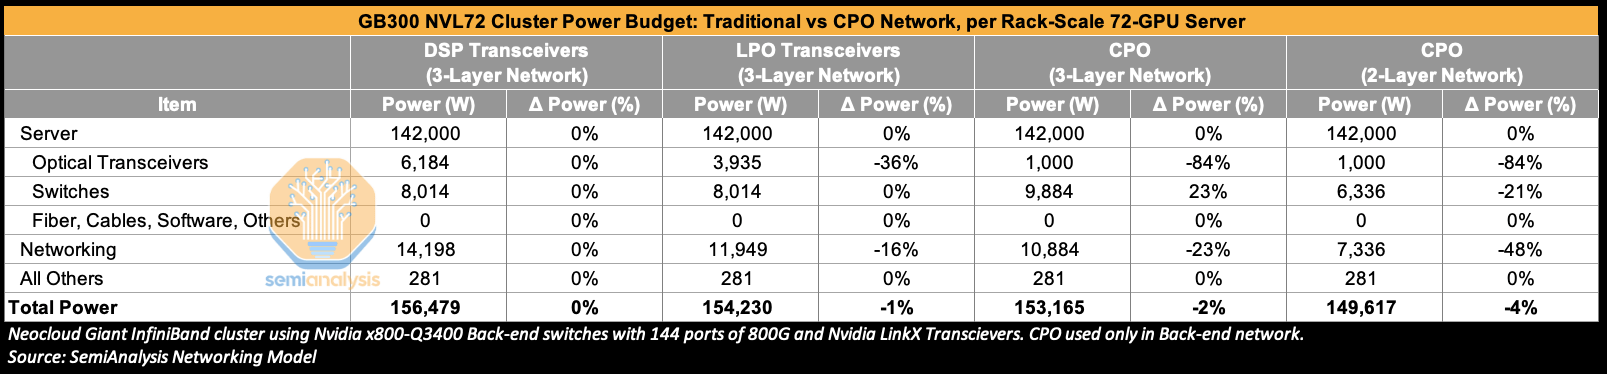
GB300 NVL72集群成本与功耗预算明细(每机架72-GPU服务器)
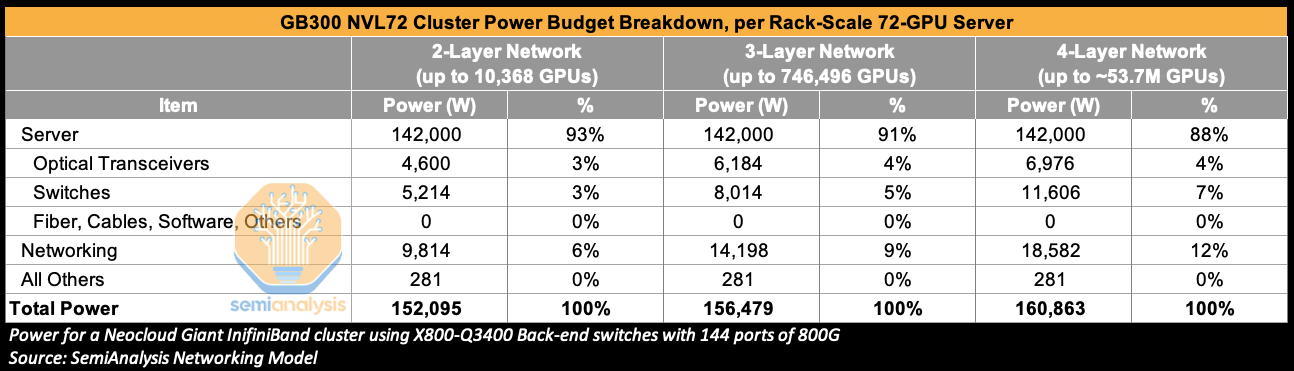
AI集群的GPU数量越多,所需的网络层级可能越多。从二层网络升级至三层及以上网络,意味着更高的成本和更大的功耗预算。CPO不仅能在保持网络层级不变的情况下降低功耗和成本,还能通过扩大单个网络层级可连接的GPU数量,进一步减少总功耗和成本需求。
◆ scale out域CPO的功耗预算
2025年GTC大会上,英伟达CEO黄仁勋强调,光模块本身的巨大功耗是推动CPO发展的关键动力。根据上述表格中的每机架功耗预算,一个包含20万个GB300 NVL72(每机架72个GPU封装、144个计算小芯片)的GPU集群,若采用三层网络,其关键IT功耗将达到435MW,其中单独光模块的功耗就高达17MW。显然,减少大部分收发器相关组件有望节省巨额功耗。
这一点可通过对比单个800G DSP光模块与CPO系统中光引擎+激光源的功耗(按800G带宽计)直观体现:800G DR4光模块的功耗约为16-17W,而英伟达Q3450 CPO交换机中的光引擎与外部激光源合计功耗约为4-5W/800G带宽,功耗降低73%。
这一数据与Meta在2025年ECOC大会上发布的论文结果高度吻合。该报告显示,800G 2xFR4可插拔收发器的功耗约为15W,而博通Bailly 51.2T CPO交换机中的光引擎与激光源合计功耗约为5.4W/800G带宽,功耗节省65%。
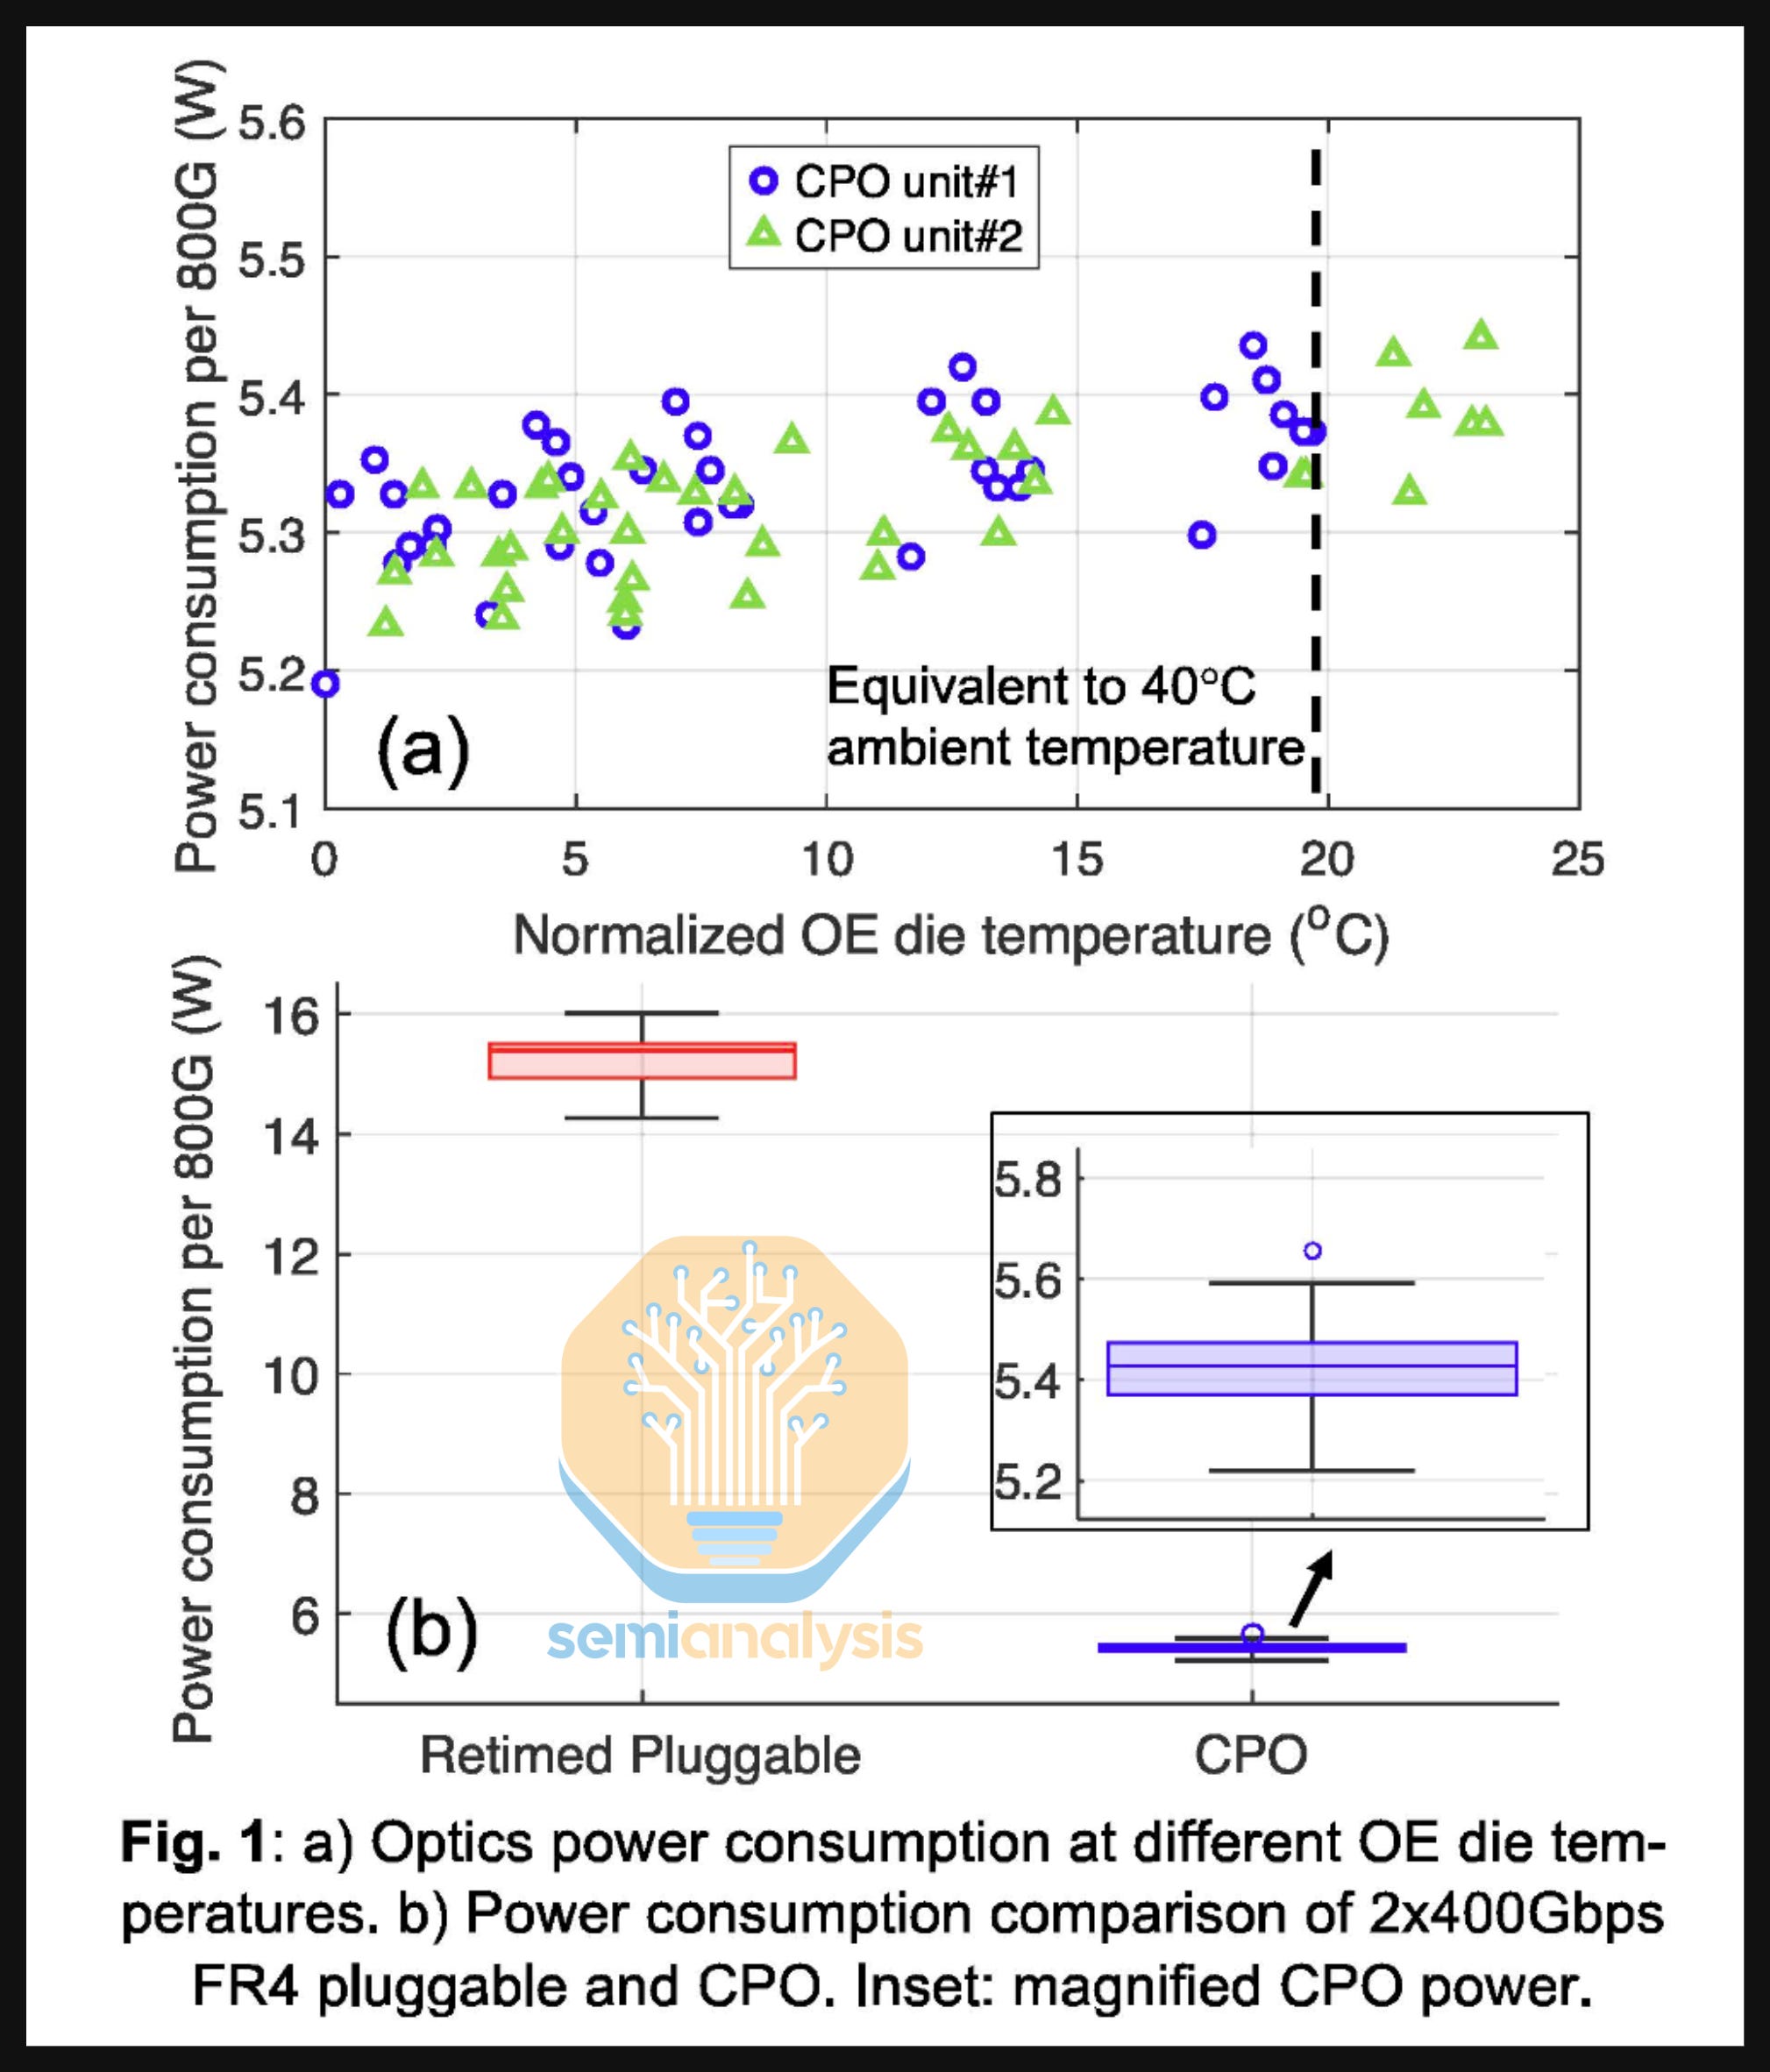
图1:(a)不同光引擎芯片温度下的光模块功耗;(b)2x400Gbps FR4可插拔模块与CPO的功耗对比(插图:CPO功耗放大图)
将分析扩展至集群层面:在采用三层网络的GB300 NVL72集群中,后端网络从DSP光模块转向LPO光模块,可使光模块总功耗降低36%,网络总功耗降低16%;而全面转向CPO的节能效果更为显著——光模块功耗降低84%,但交换机新增的光引擎(OE)和外部激光源(ELS)会使总功耗增加23%。需说明的是,在CPO场景中,前端网络仍使用DSP光模块,因此每台服务器的光模块功耗底线为1000W。
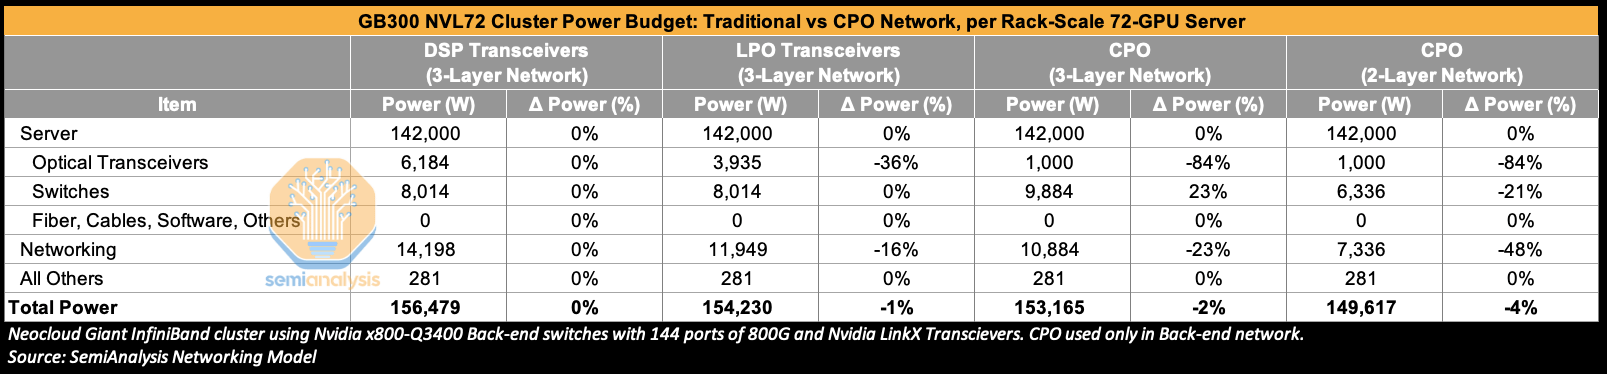
GB300 NVL72集群功耗预算:传统网络vs CPO网络(每机架72-GPU服务器)
来源:SemiAnalysis AI网络模型(基于采用144个800G端口的英伟达X800-Q3400后端交换机及英伟达LinkX收发器构建的超大规模IB集群,CPO仅应用于后端网络)
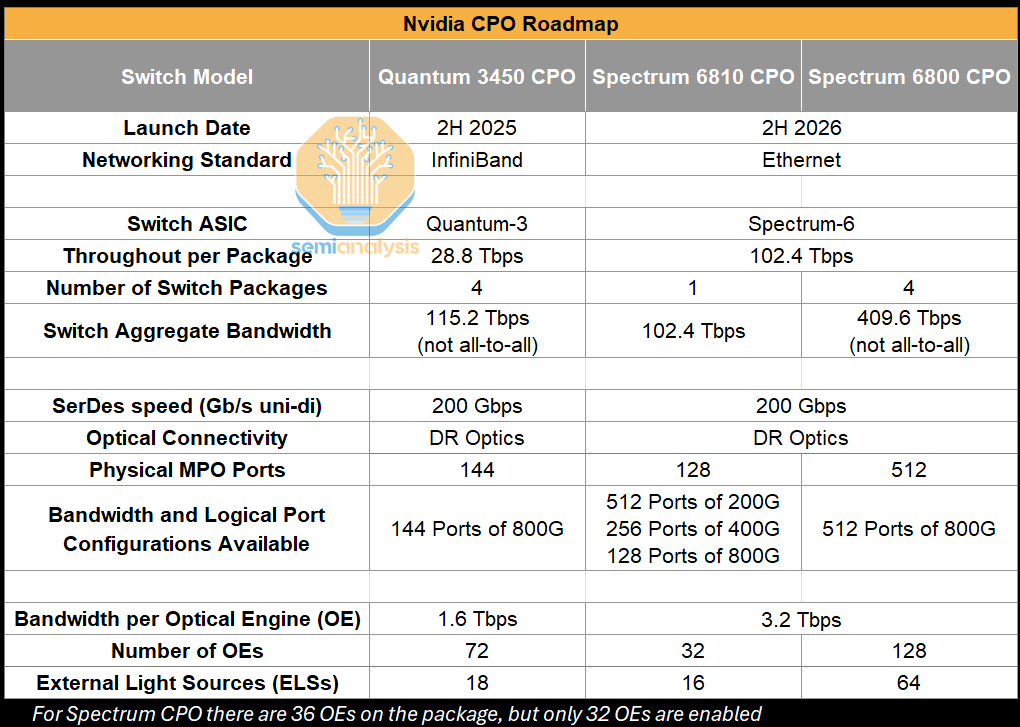
英伟达的scale out CPO交换机默认采用高基数(high radix)网络架构,但这一特性对终端用户而言是“抽象化”的——因为数据shuffle在交换机内部完成,而非像非CPO高基数交换机那样通过配线架或octopus cables在外部实现。相反,这些CPO交换机呈现出极高的端口密度:例如Quantum 3450提供144个800G端口,Spectrum 6800提供512个800G端口。需要说明的是,英伟达非CPO的IB Quantum Q3400交换机也提供144个800G端口,但其他IB交换机(如QM9700)仅提供32个800G端口——只有前者能通过“单机高基数”实现大量有效端口。
这种高端口密度使客户有望将网络从三层扁平化至二层,同时省去部署shuffle box光纤重排、配线架或笨重的octopus线缆的麻烦,这可能成为其核心卖点。在二层网络场景中,与传统DSP光模块相比,CPO的收发器功耗降低84%,交换机功耗降低21%,网络总功耗降低48%。
Spectrum 6800交换机的端口配置(512个800G端口)使其在这方面具备显著优势——相比之下,Spectrum 6810仅提供128个800G端口、256个400G端口或512个200G端口。若Spectrum 6810采用128个800G端口配置,二层网络最多可连接8192个GPU;而Spectrum 6800的512个800G端口配置可连接131072个GPU。
补充说明:一个具有k个端口的交换机在L层网络中支持的最大主机数公式为:2×(k/2)^L。例如,对于二层网络,通过将每个端口的带宽减半(如将800G端口拆分为两个400G端口),无论是通过内部重排(如Spectrum 6800)、分支线缆还是双端口收发器,支持的主机数都将变为原来的四倍!
前文提到的功耗节省(三层CPO网络降低23%网络功耗,二层CPO网络降低48%)看似显著,但需注意:三层网络中,网络功耗仅占集群总功耗的9%。因此,转向CPO对集群总功耗的影响被大幅稀释——三层CPO网络仅能使集群总功耗降低2%,二层网络也仅降低4%。
◆ scale out CPO的总拥有成本(TCO)
这里简要对比收发器与CPO解决方案的成本细节:英伟达首款CPO交换机Quantum X800-Q3450 CPO将采用72个1.6 Tbps的光引擎;后续版本的Quantum CPO交换机可能转向36个3.2 Tbps的光引擎,每个光引擎(含FAU)成本约1000美元,因此每台设备的光引擎总成本约为3.6万美元。
作为对比,若采用传统光收发器模块:非CPO的X800-Q3400交换机配备72个OSFP插槽,需使用1.6T双端口收发器提供144个800G端口。假设一款通用1.6T DR8收发器的成本为1000美元,那么为该交换机配备收发器的总成本将达到7.2万美元——是CPO交换机所需光引擎和ELS总成本(约3.5-4万美元)的两倍。
但需考虑交换机供应商的利润率:若按60%的毛利率计算,终端客户购买光引擎的成本将达到8-9万美元,高于收发器方案的成本。此外,光纤重排shuffle盒等其他组件也会面临类似的利润率叠加。这意味着,根据光模块的采购成本和交换机供应商的利润率,转向CPO的成本节省可能并不显著。
如下表所示,在三层网络中从收发器转向CPO时,CPO组件的额外利润率使交换机成本增加81%,这抵消了86%的光模块采购成本节省。尽管CPO的网络总成本仍比DSP光模块低31%,但正如功耗分析所示,服务器机架在集群TCO中占主导地位,因此集群总成本仅降低3%。
而将网络从三层扁平化至二层,可实现更显著的成本节省——集群总成本降低7%,收发器成本降低86%,网络总造价降低46%。
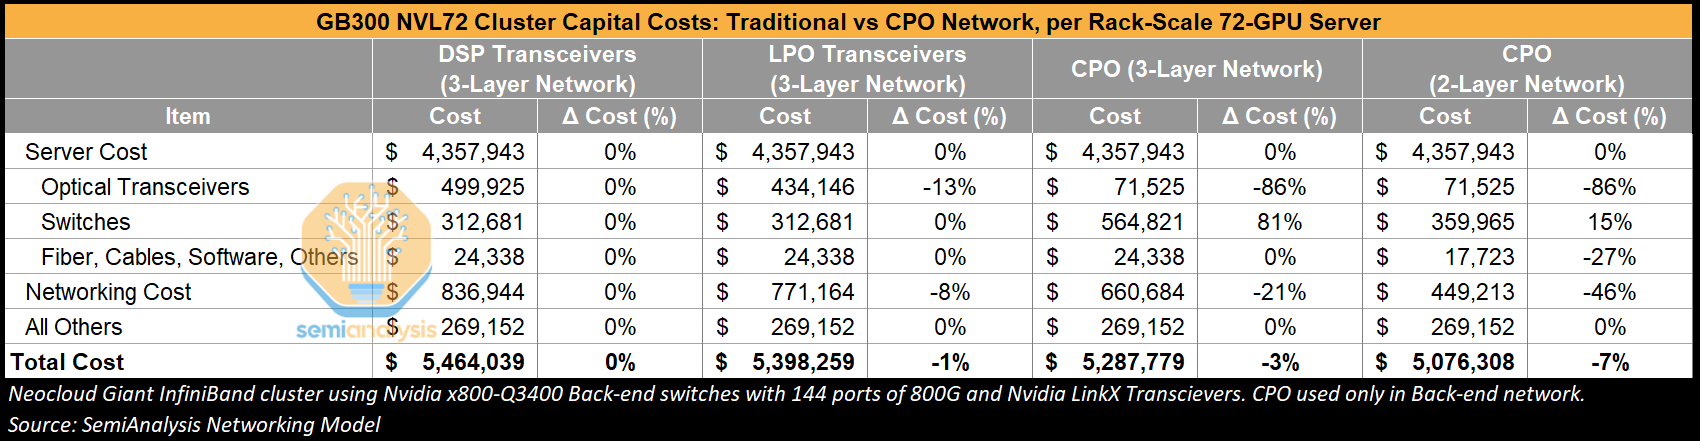
GB300 NVL72集群资本支出:传统网络vs CPO网络(每机架72-GPU服务器)
综上,CPO虽能提供最高7%的成本节省和4%的功耗节省,但同时存在现场维护难度大、可靠性及故障影响范围担忧、丧失对多个收发器供应商的议价能力等问题——这也是GPU云厂商尚未广泛采用CPO的原因。Semianalysis预计,短期内超大规模数据中心运营商对scale out CPO系统的采用不会出现快速增长。
◆ scale up网络中的CPO
与此相反,Semianalysis认为scale up是CPO的杀手级应用场景。如前所述,大型超大规模数据中心运营商已开始向供应商承诺,将在本十年末部署基于CPO的纵向扩展解决方案。
当前,基于铜缆的scale up模式正逼近极限:200Gbpa/lane速率下,铜缆的传输距离最多仅为2m,且单通道带宽翻倍的难度日益增加。而CPO不仅能满足带宽密度要求,还能提供多种未来带宽扩展路径,并解锁更大规模的scale up域。
一旦CPO应用于scale up网络,纵向扩展域将不再受互联传输距离的限制——理论上,客户可将scale up域扩展至任意规模。当然,若要保持scale up域处于支持全连接的单级扇出网络中,其规模将受限于交换机基数。
◆ Scale up vs Scale out的市场规模(TAM)
Scale up网络的需求远比后端横向扩展网络更为严苛。GPU间或交换机间的链路需要更高的带宽和更低的延迟,以实现GPU间的协同工作,例如共享内存等资源。
举例来说,英伟达Blackwell架构的第五代NVLink,每块GPU的单向带宽达900GB/s (7200Gb/s)——是GB300 NVL72后端Scale out网络(采用CX-8网卡,每块GPU带宽100GB/s,即800Gb/s)的9倍。这也推动了Host对更高岸线带宽密度的需求,成为GPU Serdes速率提升的核心动力。
更重要的是,随着Scale up域规模扩大和互联速率提升,Scale up互联(最终将是Scale up CPO)的市场规模已大幅超过Scale out网络。CPO的市场规模未来可能主要由Scale-up应用主导。
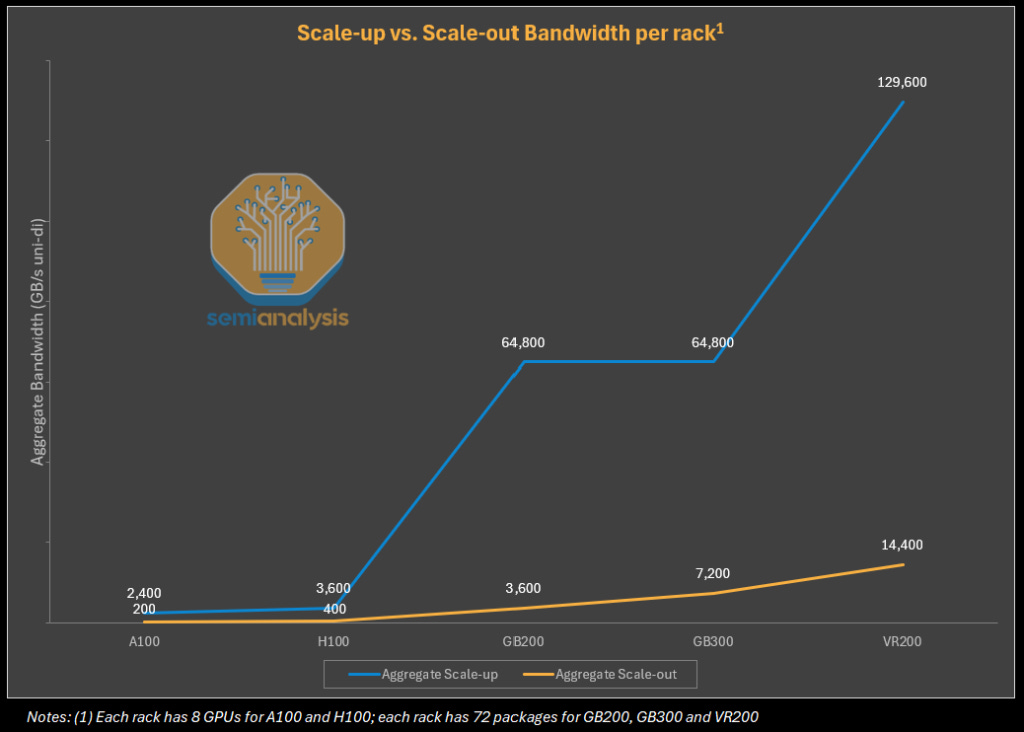
每机架Scale-out vs Scale-up带宽对比
◆ Scale-up中的铜缆vs光学:域规模、密度与传输距离
目前,Scale-up网络完全依赖铜缆,这有其合理之处:在当前可插拔范式下,若用光模块匹配NVLink的带宽,将面临极高的成本、功耗以及额外的延迟问题,且计算托盘的面板空间可能无法容纳所有必要的收发器。铜缆在低延迟、高吞吐量连接方面表现出色,但如前所述,铜缆的传输距离限制了“域规模”——即单个Scale-up域内可连接的GPU数量。
扩大Scale-up域规模是计算能力扩展的关键途径。在如今基于推理的模型扩展和测试时计算的场景中,在单个Scale-up域内增加更多计算资源、内存容量和内存带宽,已变得越来越重要。
英伟达GB200系统实现了巨大的性能飞跃,其核心原因是将Scale-up域的GPU数量从8个提升至72个(全连接拓扑),通过实现更复杂的协同通信技术,解锁了惊人的吞吐量提升——这在,Scale-out网络中是无法实现的。
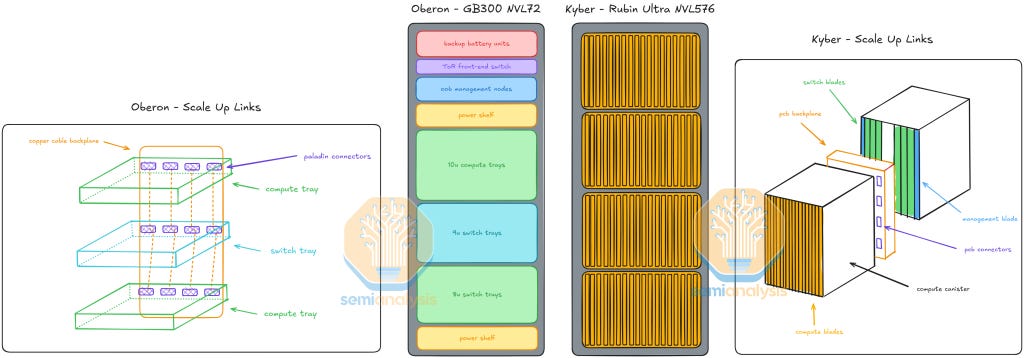
而基于铜缆的方案,只能在单个机架范围内实现这一规模,这对供电、热管理和可制造性提出了极高要求。该系统的复杂性导致下游供应链仍在努力提升产能。
英伟达将继续坚持使用铜缆,并计划进一步扩大Scale-up域规模,以领先于AMD等竞争对手及正在追赶的超大规模数据中心运营商。为此,英伟达被迫采取极端措施,在单个机架内扩展Scale-up域——2025年GTC大会展示的Rubin Ultra的Kyber机架架构,可支持多达144个GPU封装(576个GPU芯片),其密度是本已密集的GB200/300 NVL72机架的4倍。GB200的制造和部署已极具复杂性,而Kyber架构更是将其推向了新的高度。
光学技术则提供了相反的思路:通过跨多个机架扩展来增加域规模,而非在密集空间内堆砌更多加速器(这会带来供电和热密度方面的挑战)。如今的可插拔光模块虽能实现这一点,但光收发器的高成本和高功耗使其不切实际。
◆ Scale-up中的铜缆vs光学:带宽扩展
铜缆的带宽扩展也日益困难。在Rubin架构中,英伟达通过创新的双向Serdes技术实现带宽翻倍——发送和接收操作共享同一通道,支持每通道224Gbps发送+接收的全双工通信。而在铜缆上实现“真正的”每通道448Gbps,仍是一项极具挑战性的任务,上市时间尚不明确。相比之下,CPO提供了多种带宽扩展路径:波特率提升、密集波分复用(DWDM)、增加光纤对数量及调制方式升级——这些将在本文后续详细讨论。
◆ CPO何时能成熟落地?
既然CPO是解决方案,为何英伟达不将其应用于Rubin Ultra,而仅先用于横向扩展交换机?这主要源于供应链不成熟、制造挑战以及客户的部署顾虑。Quantum和Spectrum系列CPO交换机的推出,旨在帮助供应链提升产能,并获取更多数据中心实际部署中的可靠性和可维护性数据。
在此期间,Meta在ECOC大会上发布的CPO可靠性数据提供了重要参考。Meta与博通合作开展了这项研究,博通也发布了相关幻灯片。研究中,Meta对15台Bailly 51.2T CPO交换机进行了规模测试,累计测试时长达104.9万个400G端口设备小时,并公布了非零KP4前向纠错(FEC)的最大 bin 值:
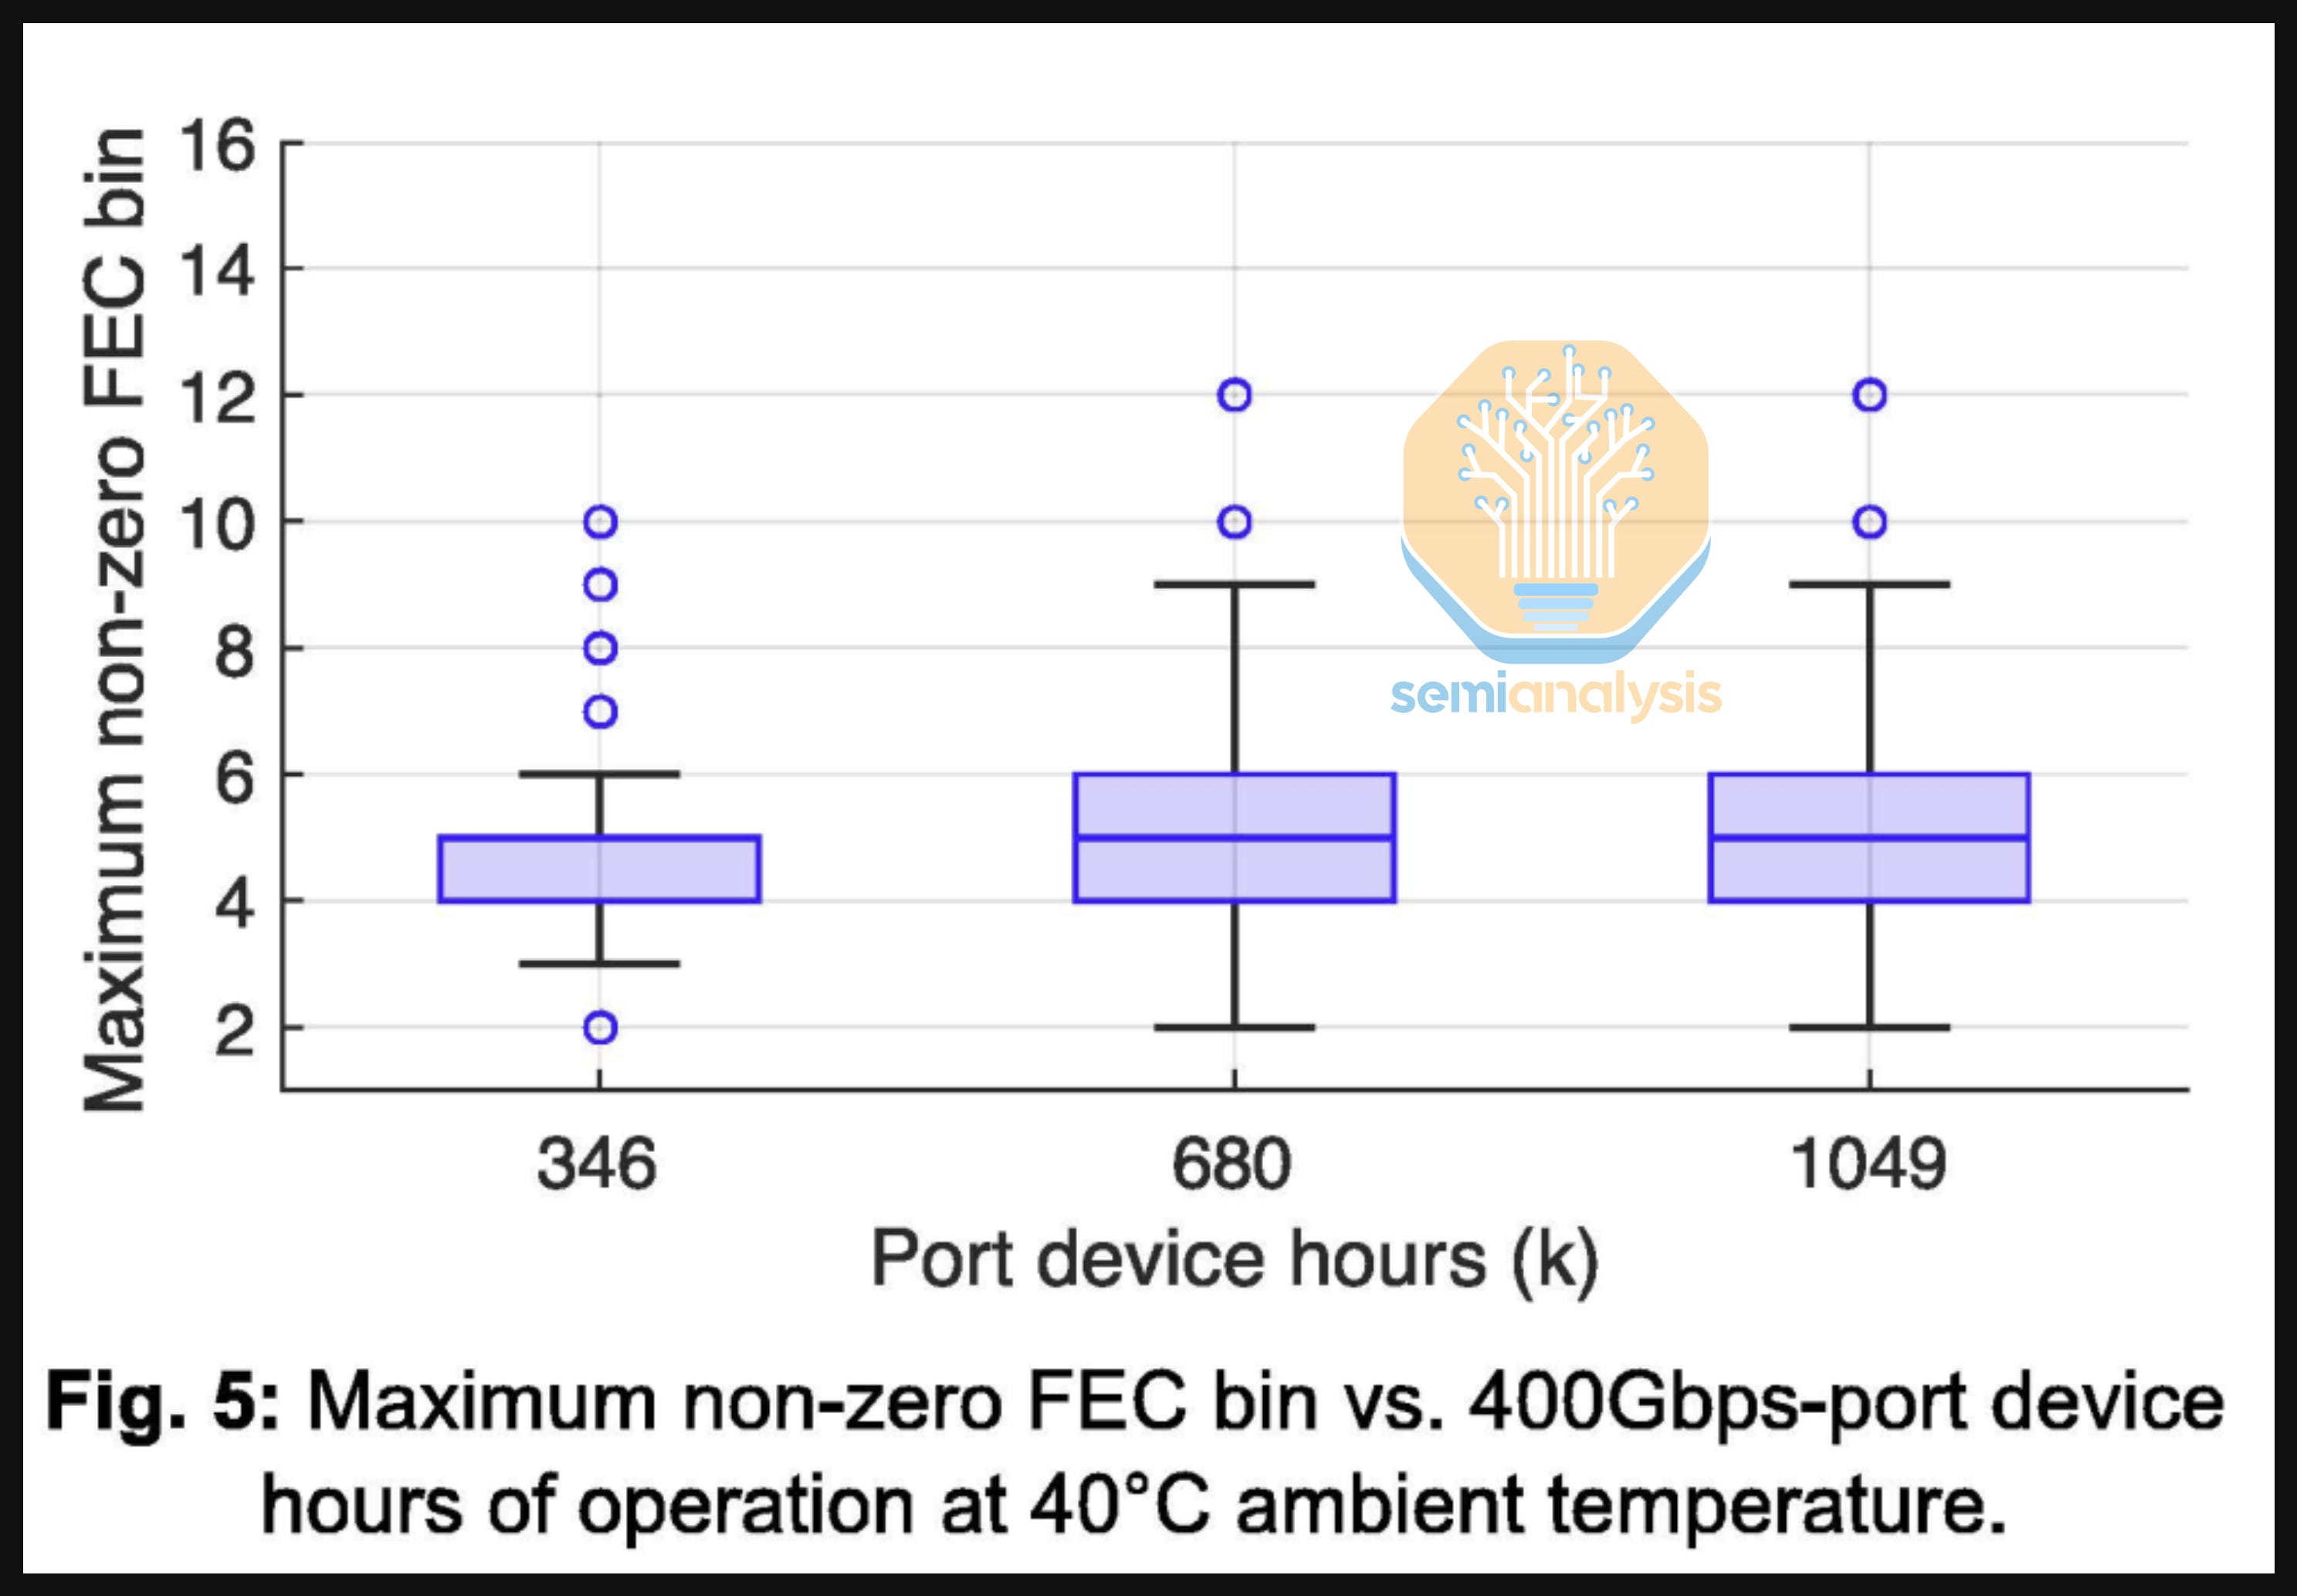
图5:40℃环境温度下,非零FEC bin最大值与400Gbps端口设备运行小时数的关系
论文还指出,测试期间未观察到链路故障或不可纠正码字(UCW),仅在累计104.9万个400G端口设备小时的测试中,出现过一次FEC bin >10的情况。
此外,Meta在ECOC大会的演讲中还公布了扩展测试结果:累计测试时长达1500万个400G端口设备小时。结果显示,前400万个400G端口设备小时内未出现任何不可纠正码字(UCW);同时,400G 2xFR4收发器的平均无故障时间(MTBF)为0.5-1百万设备小时(全球2xFR4的平均MTBF为55万设备小时),而CPO的MTBF达260万设备小时。
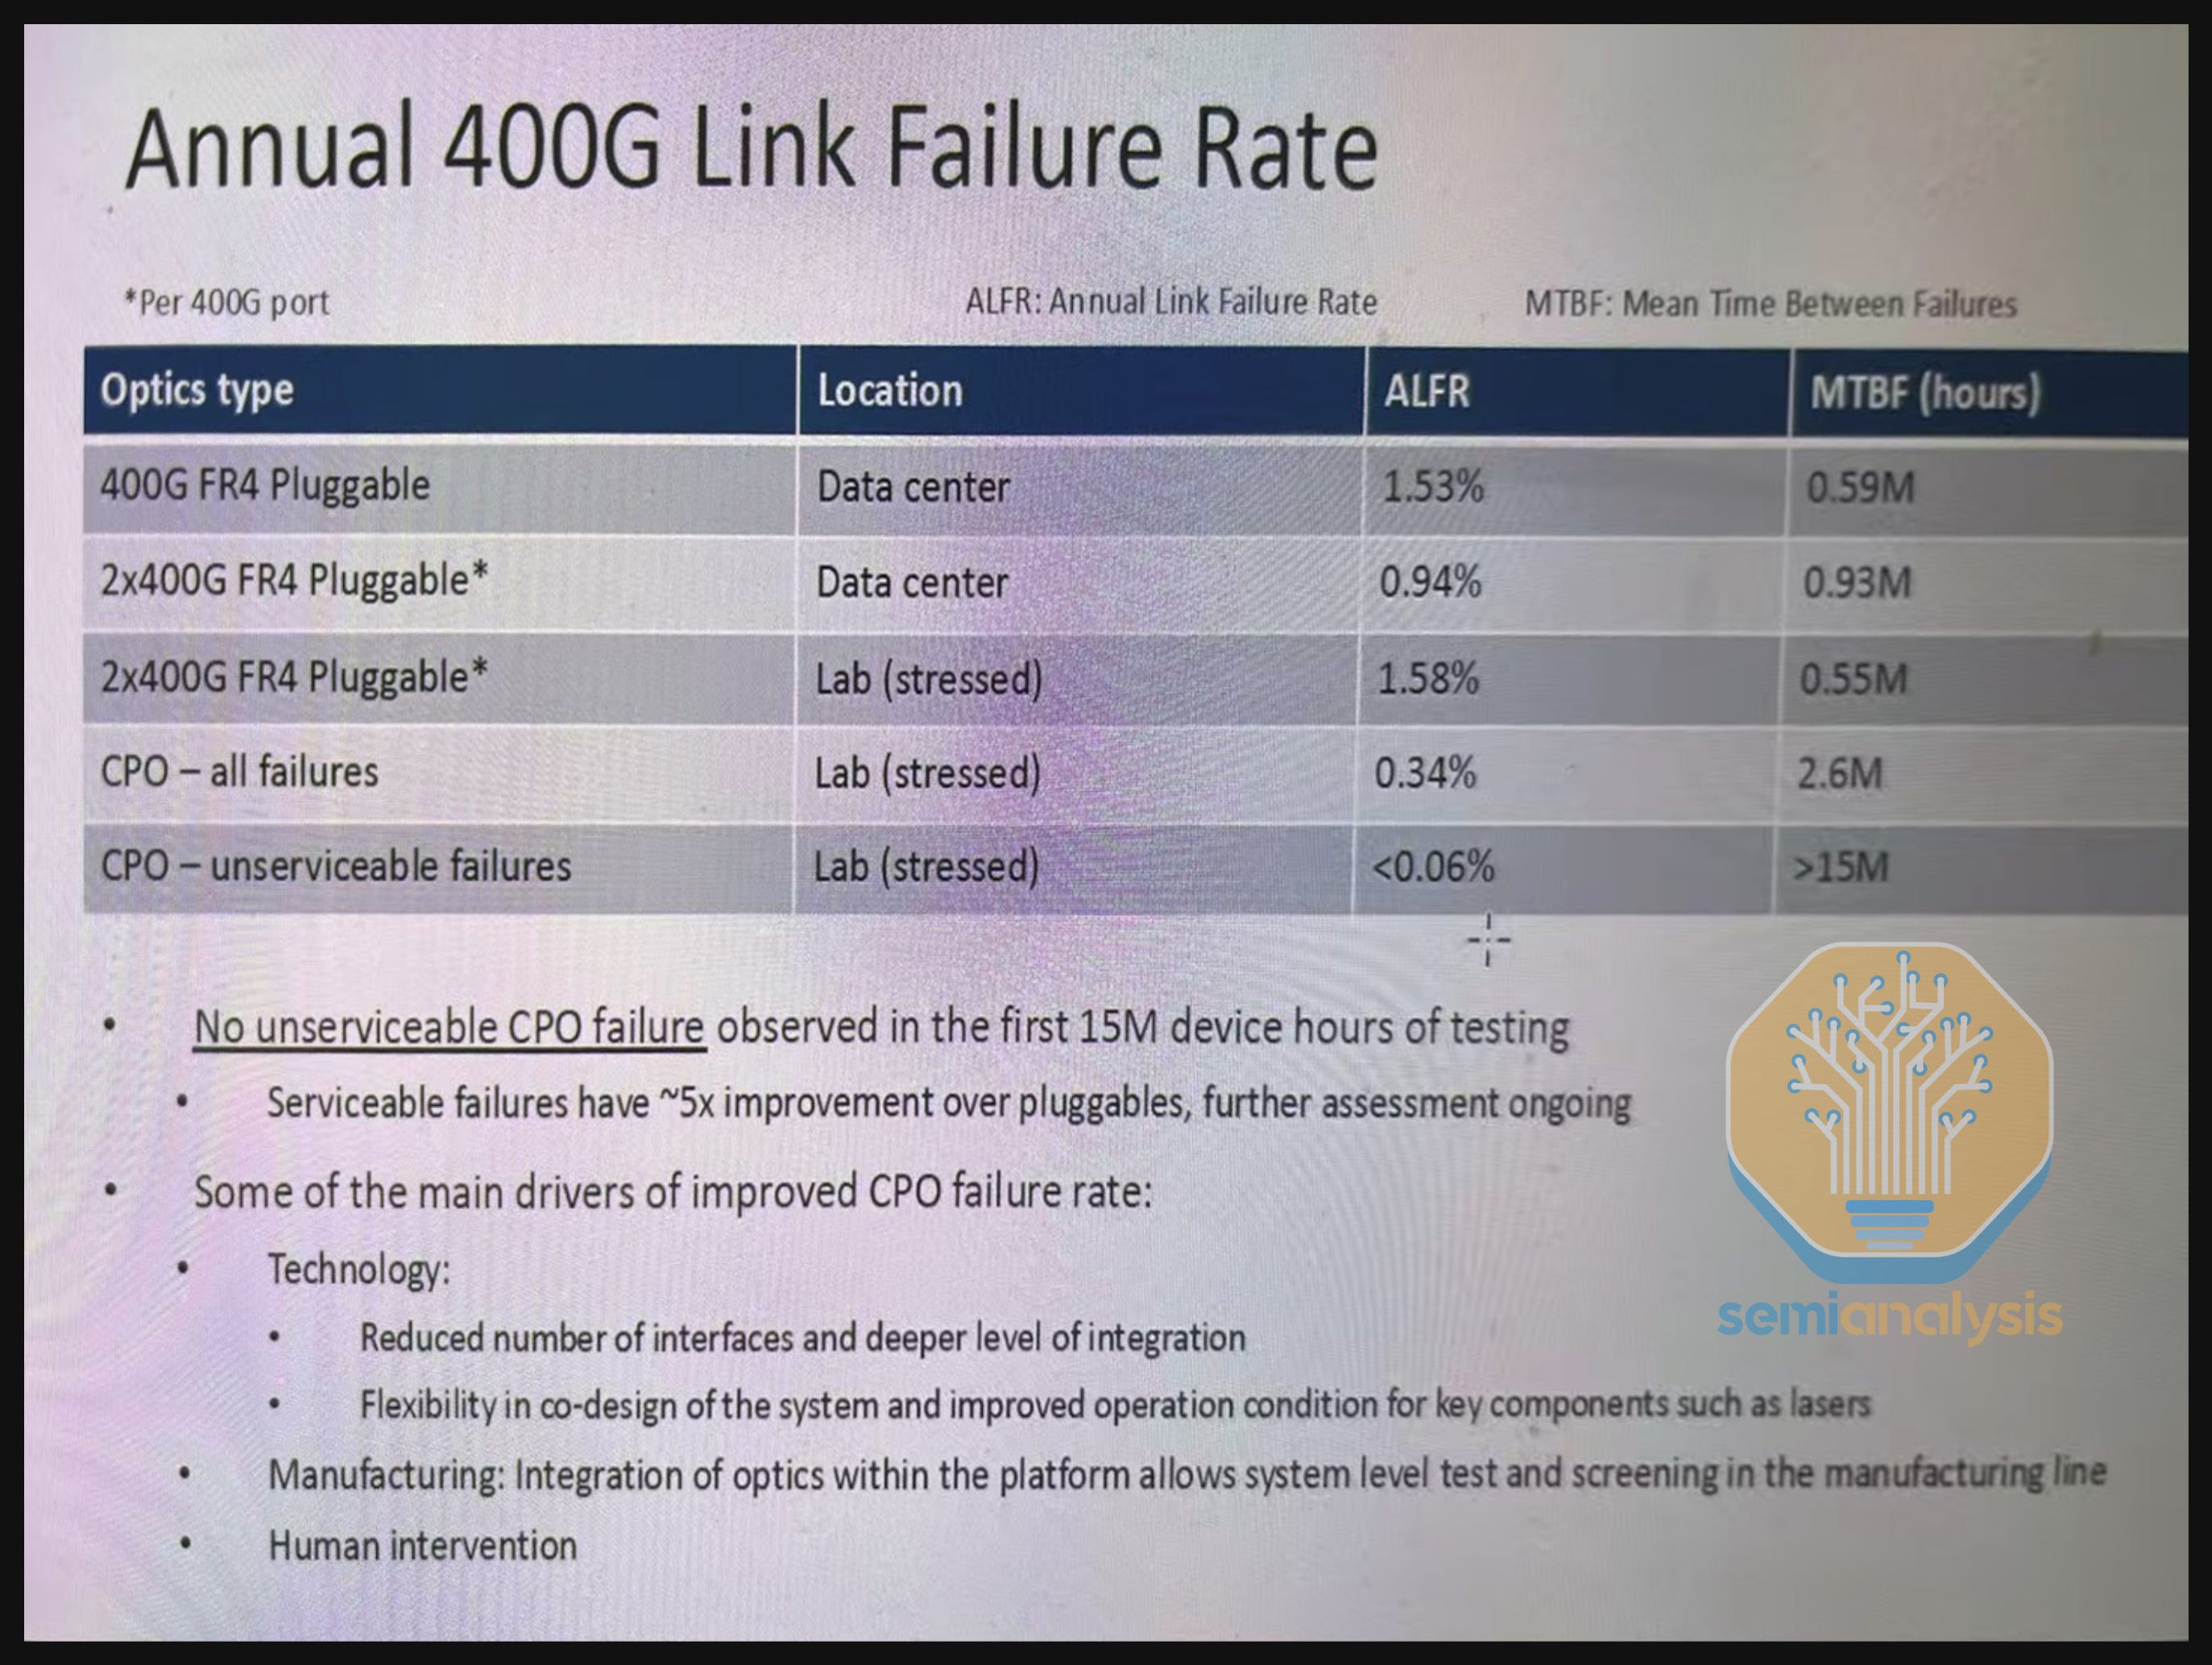
400G链路年故障率对比
(注:每400G端口;ALFR=年链路故障率;MTBF=平均无故障时间)
(注:前1500万个设备小时内未观察到CPO不可修复故障;可修复故障比可插拔模块改善5倍,后续评估仍在进行中)
◆ CPO故障率提升的主要驱动因素:
- 技术层面:减少接口数量、深度集成;系统协同设计的灵活性;关键组件(如激光)工作条件的改善。
- 制造层面:平台内光学集成支持生产线的系统级测试和筛选;减少人为干预。
尽管1500万个端口设备小时看似庞大,但这是以400G端口小时为单位计算的——例如,一台51.2T交换机运行1小时,相当于128个400G端口小时。15台51.2T交换机累计1500万个400G端口小时,相当于实际运行7812小时(约325天)。值得注意的是,1500万小时这一数字常被简化表述为“小时”或“设备小时”,而忽略了“端口”这一关键限定。
虽然前400万个端口设备小时“零故障、零不可纠正码字”的统计数据极具参考价值,但行业需要的远不止15台CPO交换机在实验室环境下11个月的测试数据——要大规模转向CPO scale out交换机并投入数十亿美元,还需更多验证。
在动态的实际部署环境中运行数千台scale out交换机,是一项完全不同的挑战,这些交换机在生产环境中的表现仍有待观察。生产环境的温度波动可能比实验室更大,可能导致组件性能或耐久性出现意外变化。Meta自身的Llama 3论文指出,数据中心1-2%的温度变化会对功耗波动产生不利影响——这种波动是否会以难以预测的方式影响整个网络结构?
一个有趣的观察是,环境因素对大规模训练性能的影响:在Llama 3 405B模型的训练中,我们发现吞吐量存在日间1-2%的波动,这是由于午间高温影响了GPU的动态电压和频率调节。训练过程中,数万个GPU可能同时增减功耗(例如,所有GPU等待检查点完成、协同通信结束,或整个训练任务启动/关闭),这可能导致数据中心功耗瞬间波动数十兆瓦,逼近电网极限。这是我们在未来更大规模Llama模型训练中面临的持续挑战。
即使是数据中心灰尘这样看似普通的问题,也让技术支持人员头疼不已——他们需花费大量时间清洁光纤端面。CPO交换机虽配备LC或MPO型前端可插拔连接器,但交换机机箱内部的灰尘问题如何解决?
0.06%的不可修复故障率看似诱人,但此类故障的影响范围可能覆盖64个800G端口。
此外,该论文聚焦于基于FR光模块的CPO交换机,而下一代CPO交换机将基于DR光模块。这些只是已知的未知问题,实际部署中可能还会出现更多不可预见的挑战。
诚然,这些结果通过提供切实的可靠性数据,已在行业内产生了积极影响。我们的核心观点并非制造恐慌、不确定性和疑虑(FUD),而是呼吁进行更大规模的实际部署测试,以便行业快速发现并解决潜在问题,为CPO的广泛应用(尤其是纵向扩展网络)铺平道路。
归根结底,英伟达Scale-outCPO产品的推出,是为真正的大规模部署进行的“实战演练”和“管道疏通”。Semianalysis认为,鉴于scale up在TCO和性能/TCO方面具有更显著的优势,其部署规模和影响将远大于横向扩展。
此外,就Scale out CPO而言,Rubin Ultra计划于2027年推出(预计实际上市时间为2027年末),而供应链届时将无法满足数千万个CPO端点的GPU需求——即便是这一时间线,对英伟达而言也过于激进。因此,Feynman系列似乎将成为CPO融入英伟达生态系统的核心节点
接下来将深入探讨CPO的核心技术、技术考量、挑战及当前生态系统状况。