2. 共封装光学(CPO)简介与实现方案
◆ 什么是CPO?为何备受关注?
CPO将光引擎直接与高性能计算或网络ASIC封装在同一封装体或模块中。这些光引擎负责将电信号转换为光信号,实现通过光链路的高速数据传输。当数据传输距离超过数米时,必须使用光链路——因为高速电信号通过铜缆无法传输如此远的距离。
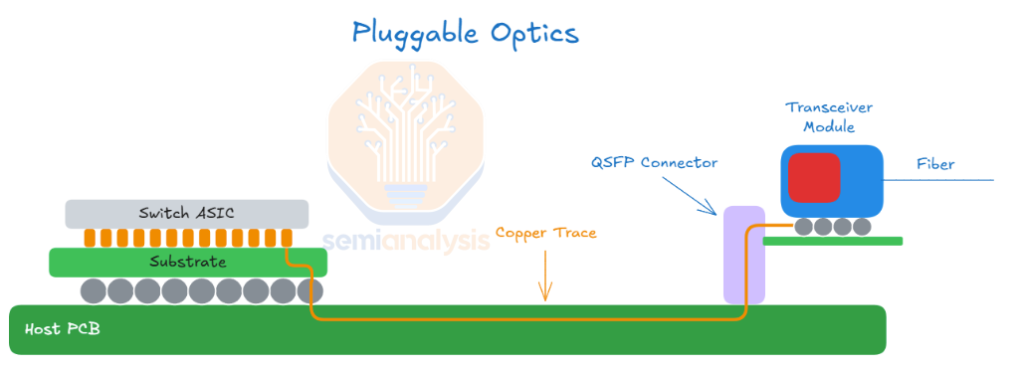
如今,大多数电光转换通过可插拔光模块实现:电信号从交换机或处理芯片出发,通过PCB传输数十厘米甚至更远距离,到达机箱前面板或后面板的物理收发器插槽,可插拔光模块便插入该插槽。收发器接收电信号后,由oDSP芯片重新恢复,再发送至光引擎组件,将电信号转换为光信号。光信号通过光纤传输至链路另一端,另一台光模块反向执行这一过程,将光信号转换回电信号,最终传输至目标芯片。 在这一过程中,电信号需在铜缆上传输相对较长的距离(至少对铜缆而言),且经过多个转接点后才能进入光链路。这会导致电信号衰减,需要大量功耗和复杂的电路(serdes)来驱动和恢复信号。
为改善这一状况,需要缩短电信号的传输距离——这正是“共封装光学”的核心思路:将原本位于可插拔收发器中的光引擎,与主机芯片共封装。 这使得电信号传输距离从数十厘米缩短至数十毫米(因为光引擎紧邻XPU或交换机ASIC),通过最小化电互联距离、缓解信号完整性问题,显著降低功耗、提升带宽密度并减少延迟。
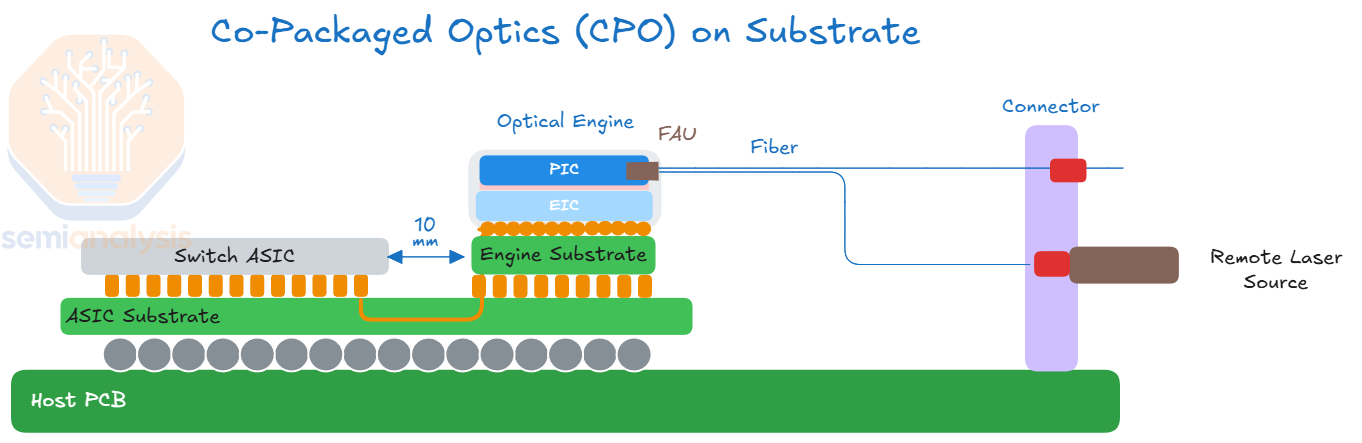
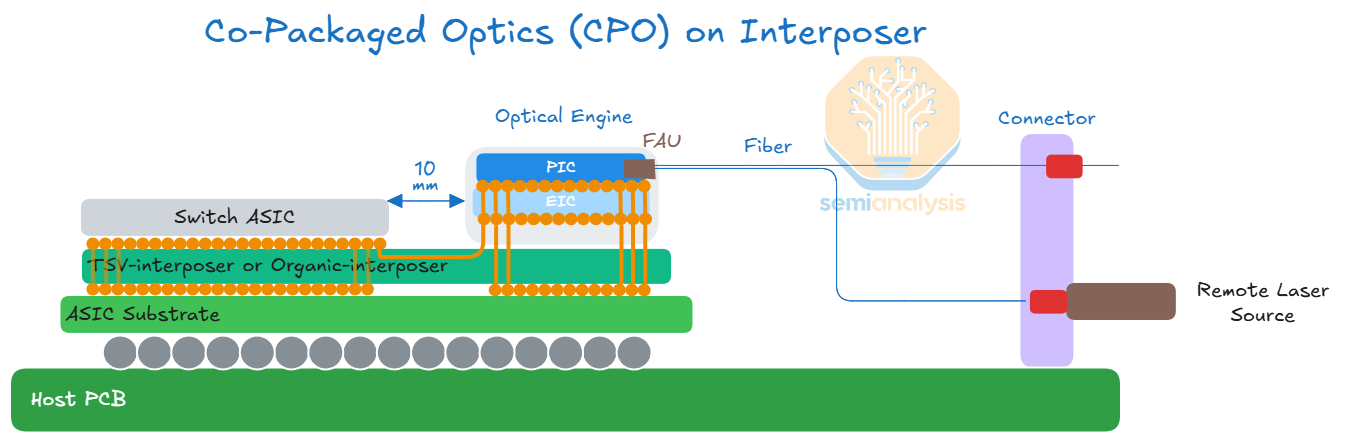
以下示意图展示了CPO的实现方案:光引擎与计算或交换机芯片位于同一封装体中。光引擎最初将部署在基板上,未来可能会迁移至中介层。
如今,如以下示意图所示的前端可插拔光学方案已被广泛采用。该示意图的核心是展示:电信号需通过铜质走线或飞线电缆传输15-30厘米,才能到达收发器中的光引擎。如前所述,这也需要长距离(LR)serdes来驱动可插拔模块。
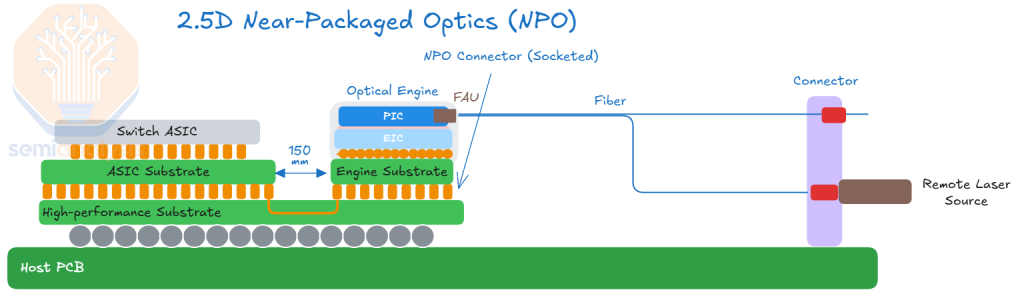
此外,在CPO与传统前端可插拔光学之间,还存在一些中间实现方案,例如近封装光学(NPO)和板上光学(OBO)。
近年来,NPO已成为迈向CPO的中间步骤。NPO有多种定义,其核心是光引擎不直接位于ASIC的基板上,而是共封装在另一块基板上。光引擎仍保持可插拔性,可与基板分离。电信号需从XPU封装上的串并转换器,通过铜质通道传输至光引擎。
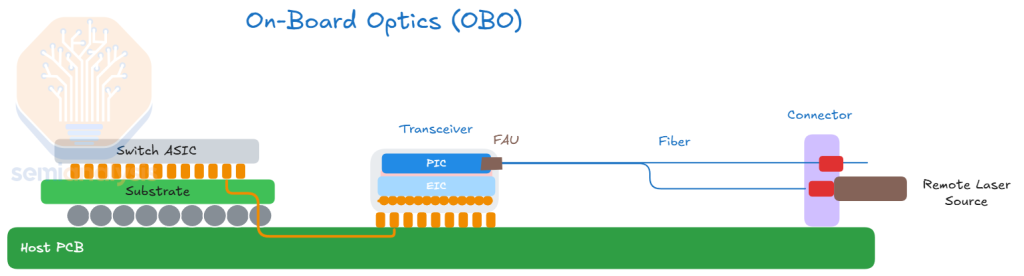
板上光学(OBO)则将光引擎集成在机箱内部的系统PCB上,使其更靠近主机ASIC。但OBO继承了CPO的诸多挑战,却在带宽密度和功耗节省方面的收益较少——SA认为OBO是“两头不讨好”的方案,既保留了可插拔光学的部分局限性,又承担了CPO的复杂性。
◆ 共封装铜缆(CPC)
CPO的另一种替代方案是“共封装铜缆(Co-packaged Copper, CPC)”。CPC的铜缆直接从基板上的连接器引出,所使用的电缆与飞线电缆相同,核心目的是绕过PCB走线。CPC进一步优化了飞线电缆方案:将插座直接集成在封装基板上。CPC使用的双轴电缆(Twinax cables)具有良好的绝缘性,可减少串扰,与传统电走线相比,插入损耗显著降低。
尽管仍使用铜缆,但CPC在信号完整性方面具有关键优势,有望成为部署448G串并转换器的实用路径,支持封装外互联的进一步扩展。
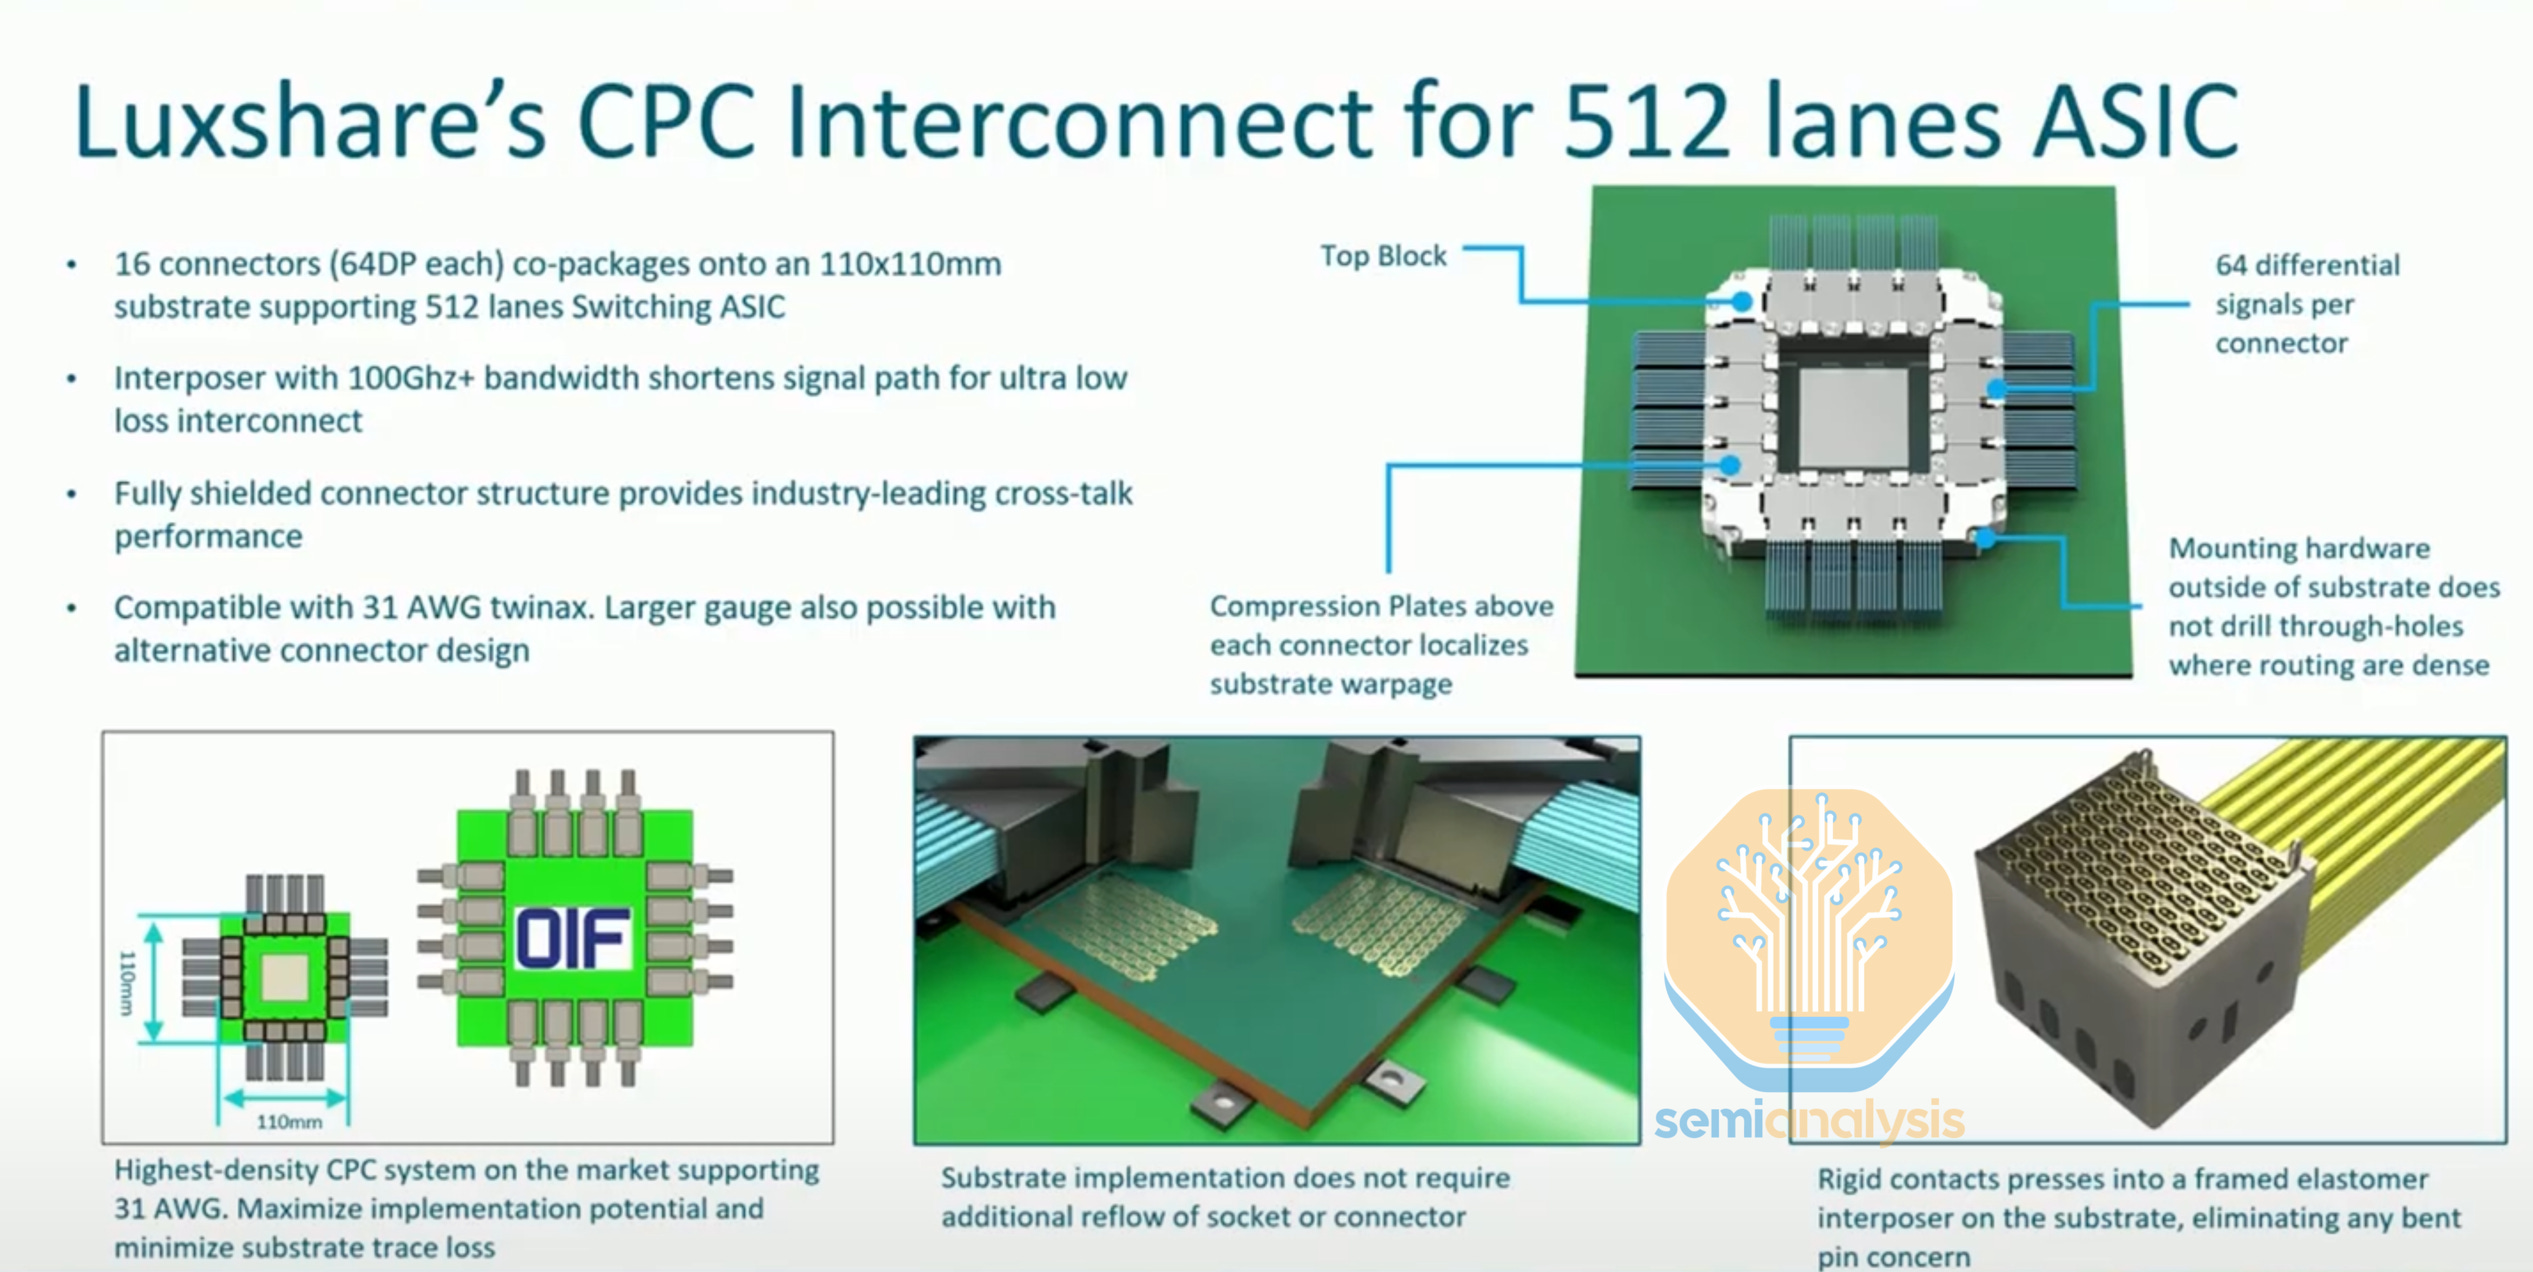
CPC的挑战在于封装基板的复杂性增加——基板需为数千根电缆提供电源和信号布线。尽管如此,CPC仍比CPO简单得多,后者需克服供应链多个环节的制造障碍。我们认为,CPC在机架内scale up互联等短距离应用中具有特别的吸引力(下文将详细探讨)。通过绕过损耗较大的CCL走线,CPC有望成为支持448G速率的关键技术。此外,由于448G带宽的信号通过PCB传输时衰减过大,CPC也被广泛视为实现448G速率的重要方案。
◆ CPO市场化滞后的原因:为何直到现在才兴起?
尽管在技术上具有优势,但CPO的实际应用一直非常有限,主要源于多个推高成本的挑战:封装复杂性(封装成本甚至超过光引擎本身)、制造难度、可靠性和良率担忧,以及光电器件紧密集成带来的热管理问题。此外,行业缺乏统一标准,客户对可维护性的担忧也阻碍了从传统可插拔光学向CPO的转型。
客户的另一大顾虑是,采用CPO可能会丧失成本控制权——与少数交换机供应商相比,向众多光模块供应商施压以降低成本要容易得多。 与此同时,作为CPO替代方案的可插拔光学技术持续迭代,其性能对于几乎所有应用场景都已足够,且能显著降低终端用户的顾虑。
本部分剩余内容将深入探讨CPO的应用动力:首先解释serdes的扩展为何已逼近瓶颈,使得宽IO等与CPO结合的接口类型成为必要;然后探讨制造考量和市场化路径;最后详细介绍CPO的关键组件(如光引擎、光纤耦合、外部激光源和调制器)及带宽扩展路线图。
◆ 超越DSP收发器:从LPO到CPO
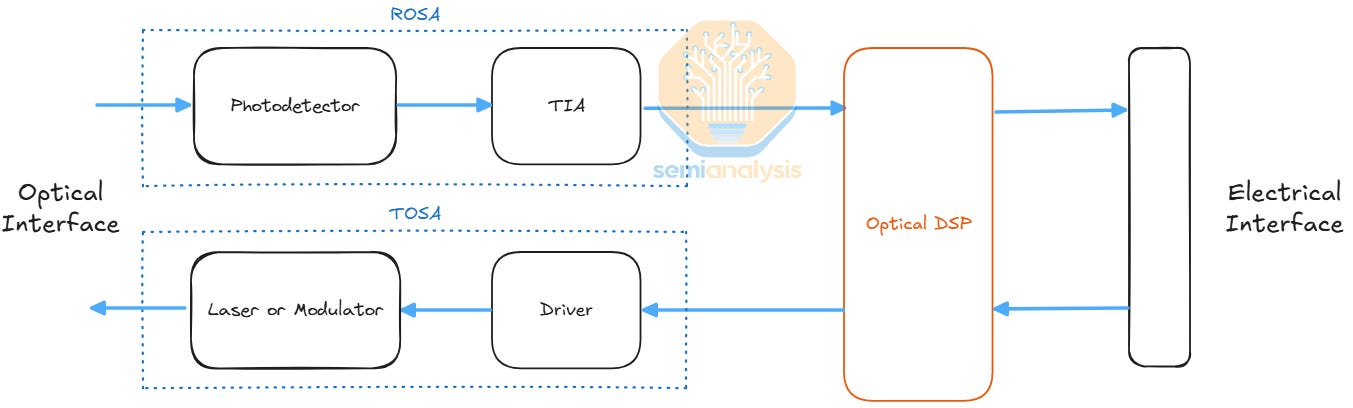
DSP光模块负责光信号的发送和接收,包含一个“光引擎(OE)”,用于实现电光转换。光引擎由发送端的DRV和调制器(MOD),以及接收端的TIA和光电探测器(PD)组成。 另一个关键组件是光DSP芯片,有时会将DRV和/或TIA集成在同一封装中。
从Host交换机或处理芯片发送的高频电信号,需通过损耗较大的铜质走线传输相对较长的距离,才能到达服务器机箱前端的收发器。DSP的核心作用是对该信号进行重定时和重新调理,通过纠错和时钟/数据恢复,补偿信号从交换机或ASIC芯片经过基板等传输介质时产生的衰减和失真。
在调制方面,以PAM4为例,DSP将二进制信号映射为四个不同的幅度等级,以增加每个信号承载的比特数,从而实现更高的比特率和带宽。
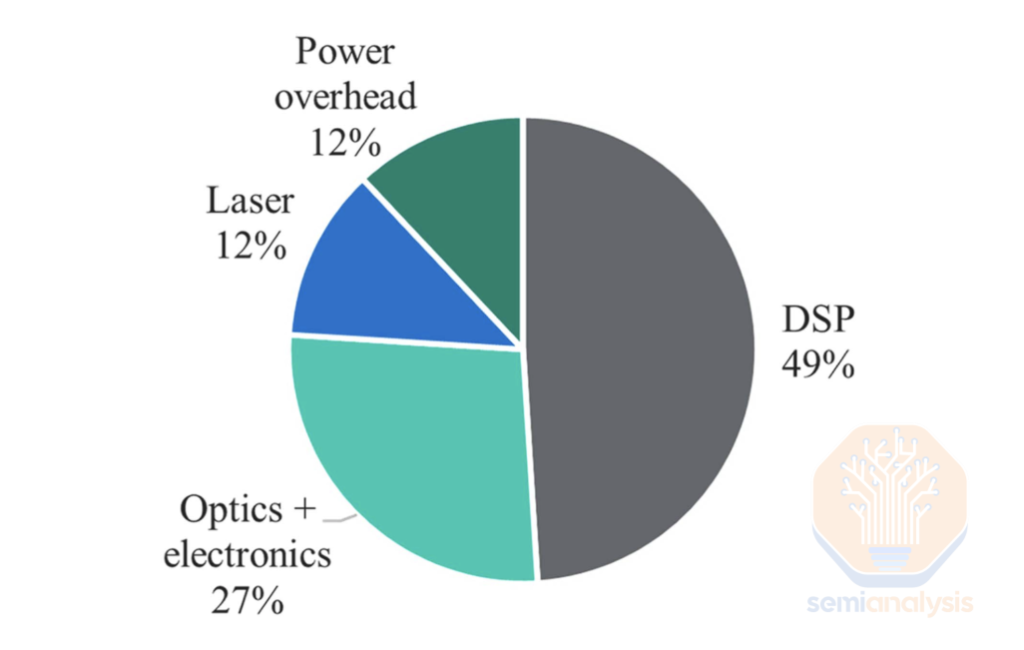
DSP芯片是光模块中功耗最高、成本最高的组件之一(甚至没有之一)。以800G SR8收发器为例,DSP占模块总功耗的近50%——这也是行业致力于摒弃DSP的核心原因。
一个包含18000个GB300的集群(采用二层IB网络),需要18432个800G DR4收发器和27648个1.6T DR8收发器。DSP带来的额外成本和功耗,会显著增加总拥有成本:假设800G DSP的功耗为6-7W,1.6T DSP的功耗为12-14W,仅后端网络的DSP总功耗就将达到480kW(约每服务器机架1.8kW)。
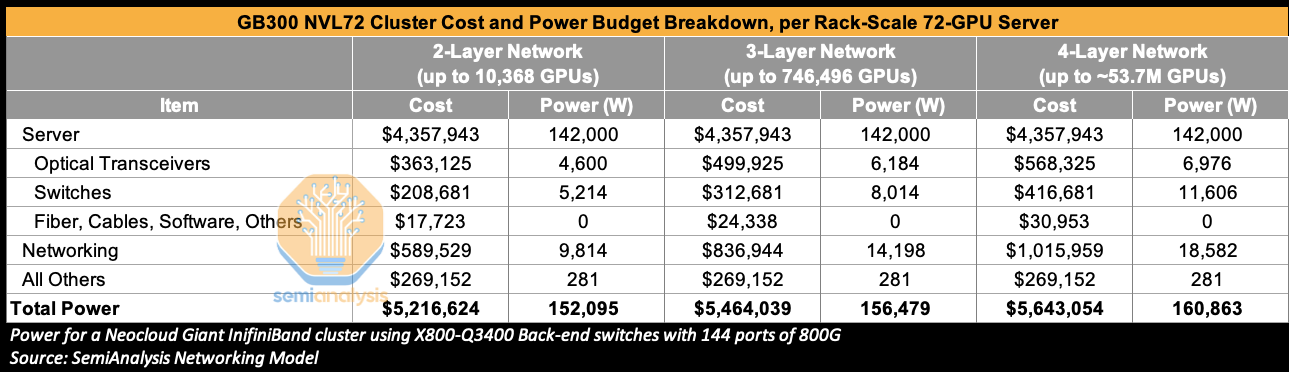
若采购高端品牌供应商的光模块,其成本可能占集群总拥有成本的近10%。因此,占据光模块50%功耗和20-30%物料成本的DSP,被不少人视为成本和能效的“头号敌人”。
◆ 向DSP宣战
DSP的高成本和高功耗占比,促使行业寻找摆脱DSP的技术方案。第一波尝试是线性可插拔光学(LPO)——试图完全摒弃DSP,让交换机的serdes直接驱动收发器中的发射和接收光学元件。
然而,正如2023年采访DSP专家Loi Nguyen时他所预测的那样,LPO尚未实现大规模应用。 CPO将LPO的理念推向了极致:将光引擎与计算或交换机芯片共封装。CPO的核心优势之一是不再需要收发器中的DSP——因为host与光引擎的距离极短。
此外,CPO比LPO更进一步:通过摒弃功耗和面积密集的LR serdes,转而使用短距离serdes,甚至在宽IO接口场景下使用时钟转发的宽域芯片间(D2D)串并转换器,解锁了更高的芯片岸线密度。
常有人说,CPO“近在眼前”已有二十年——但为何长期未能落地?行业为何更倾向于坚持使用可插拔DSP光模块?
可插拔光模块的一大核心优势是高度互操作性:通过OSFP、QSFP-DD等标准封装形式,以及遵循OIF标准,客户可独立选择收发器供应商(与交换机和服务器供应商无关),获得采购灵活性和更强的议价能力。 另一大优势是现场可维护性:收发器的安装和更换非常简单,只需技术人员手动插拔即可。相比之下,CPO的光引擎若发生故障,可能导致整个交换机无法使用;即使是可修复故障,排查和维修也更为复杂。
激光是最常见的故障点之一,如今大多数CPO方案采用可插拔的外部激光源,以提升可维护性和可更换性,但客户对其他非可插拔CPO组件的故障担忧仍未消除。
◆ 为何选择CPO?IO挑战、带宽密度与瓶颈
除了摒弃高功耗、高成本的DSP,以及最大限度减少或避免使用LR serdes外,CPO的另一大核心优势是更高的“带宽密度/能耗比”。 带宽密度衡量单位面积或单位通道传输的数据量,反映有限空间内实现高速数据传输的效率;能效则量化传输单位数据所需的能量。因此,“带宽密度/能耗比”是评估互联技术优劣的关键指标——当然,理想的互联技术还需满足距离和成本要求。
如下列图表所示,一个明确的趋势是:随着距离增加,电链路的这一指标呈指数级下降;此外,从纯电接口转向需要电光转换的接口时,效率会大幅下降(可能达一个数量级)。这是因为信号从芯片传输到前端面板的收发器需要消耗能量,而光DSP的功耗则更高。
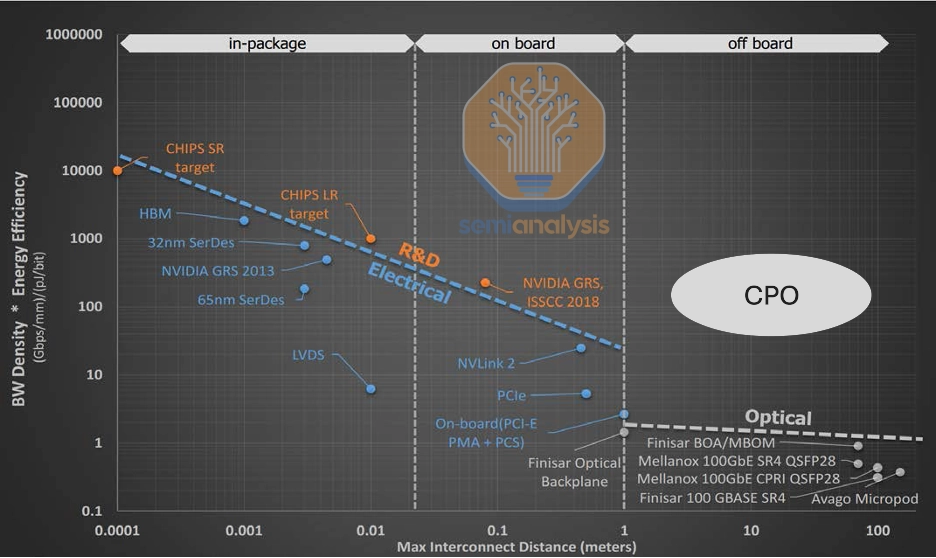
CPO通信的指标曲线明显高于可插拔光学——在相同传输距离范围内,CPO提供更高的单位面积、单位能耗带宽密度,是客观上更优的互联方案。
该图表也印证了一句行业格言:“能用电的地方就用电,必须用光的时候才用光”。短距离铜缆通信在可行的情况下具有优势——英伟达正是这一理念的践行者,其机架级GPU架构致力于突破机架内密度极限,最大限度增加可通过铜缆互联的GPU数量。这也是GB200 NVL72采用纵向扩展网络架构的核心逻辑,而英伟达在Kyber机架中更是将这一理念推向了极致。
然而,随着CPO技术的成熟,其在指标曲线上的优势将使其在Scale-up场景中具备实用价值,且在性能/TCO方面的收益将值得投入。
◆ IO的障碍与瓶颈
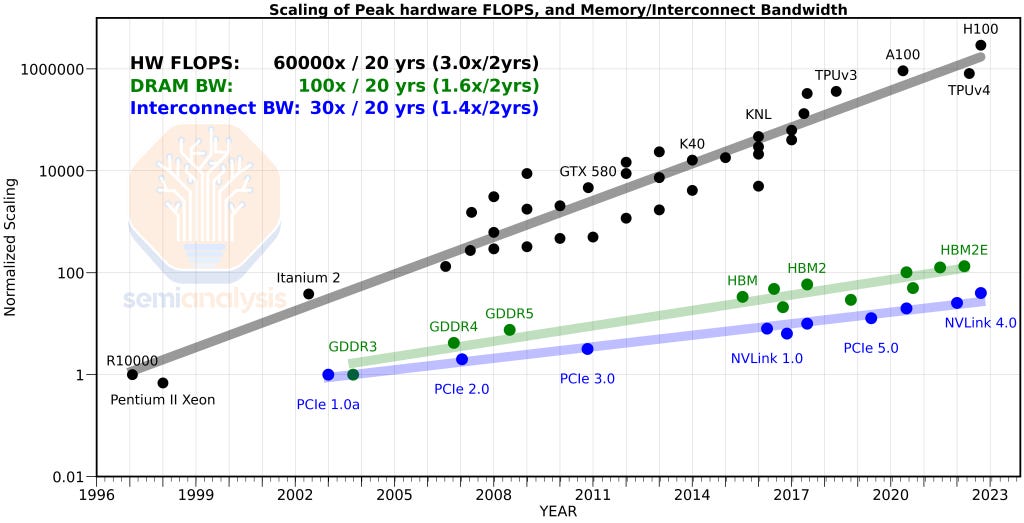
尽管晶体管密度和计算能力(以浮点运算次数FLOPs为代表)已实现良好扩展,但IO的扩展速度要慢得多,成为系统整体性能的瓶颈:有机封装基板上的片外IO数量有限,数据需通过这些有限的IO输出芯片。
此外,提高单个IO的信号速度正变得越来越具挑战性且功耗高昂,进一步限制了数据传输。这也是过去几十年来,互联带宽相对于其他计算领域趋势扩展缓慢的关键原因。
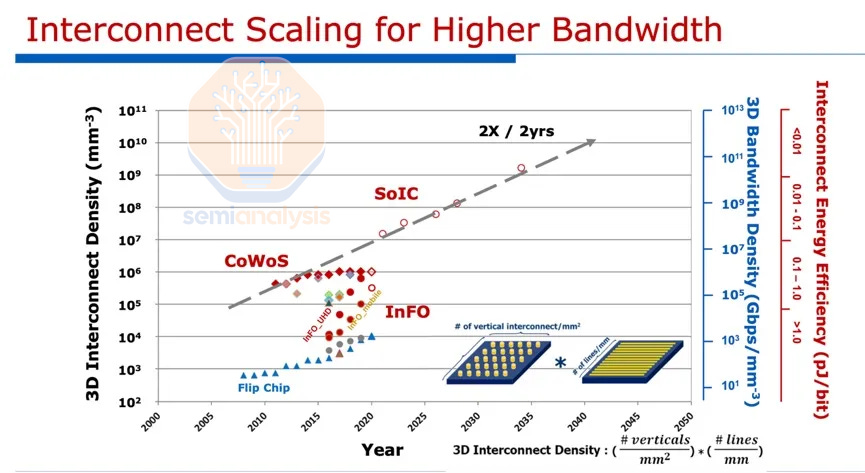
高性能计算(HPC)应用的封装外IO密度已趋于平稳,这主要受限于单芯片倒装球栅阵列(BGA)封装的凸点数量——这是扩展输出带宽的一大制约因素。
◆电serdes的扩展瓶颈
在IO数量有限的情况下,实现更高输出带宽的关键是提高每个IO的信号频率。如今,英伟达和博通在serdes IP领域处于领先地位:英伟达在Blackwell架构中部署了224G serdes,支撑其高速NVLink;博通则从2024年末开始在其光DSP中采用224G serdes。行业内出货AI浮点运算能力最强的两家公司,同时在高速serdes IP方面领先——这并非巧合,而是印证了AI性能与吞吐量之间的核心关联:最大化数据传输效率与提供原始计算能力同等重要。
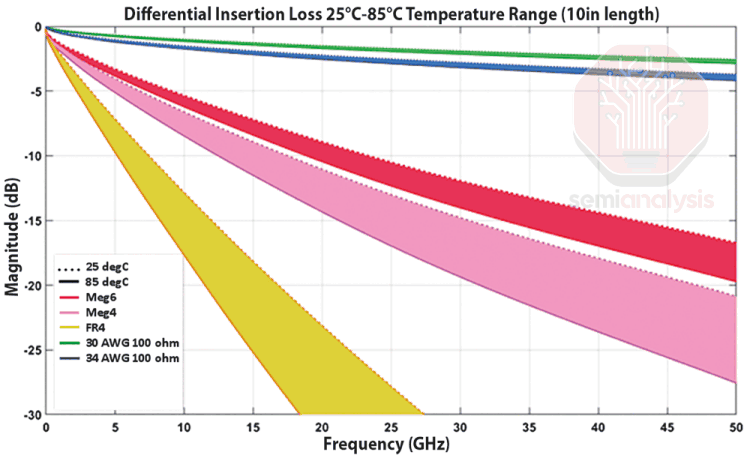
然而,在保持理想传输距离的同时提高线速,正变得越来越具挑战性。随着频率增加,插入损耗会上升(如下列图表所示):serdes信号速度越高,信号路径越长,损耗越大。
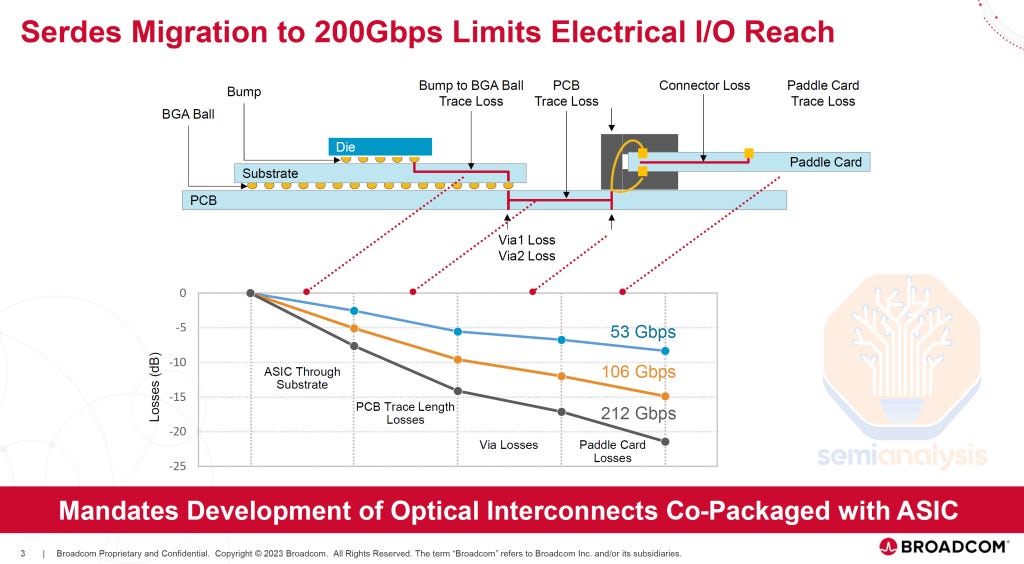
serdes的扩展已逼近平台期:更高的速度仅能在极短距离内维持,否则需要额外的信号恢复组件——这会进一步增加复杂性、成本、延迟和功耗。224G serdes的实现已极具挑战性。 展望448G serdes,其能否驱动信号传输超过几厘米,仍存在较大不确定性。
英伟达在Rubin架构中,通过双向serdes技术实现了每电通道448G的互联;而实现真正的单向448G serdez,还需要进一步的技术突破——可能需要采用更高阶的调制方式(如PAM6或PAM8),取代自56G serdes时代以来广泛使用的PAM4调制。若使用PAM4(每个信号编码2比特)实现448G速率,需要244G波特率,这可能因功耗过高和插入损耗过大而难以实现。
◆ serdes扩展平台期:NVLink扩展的瓶颈
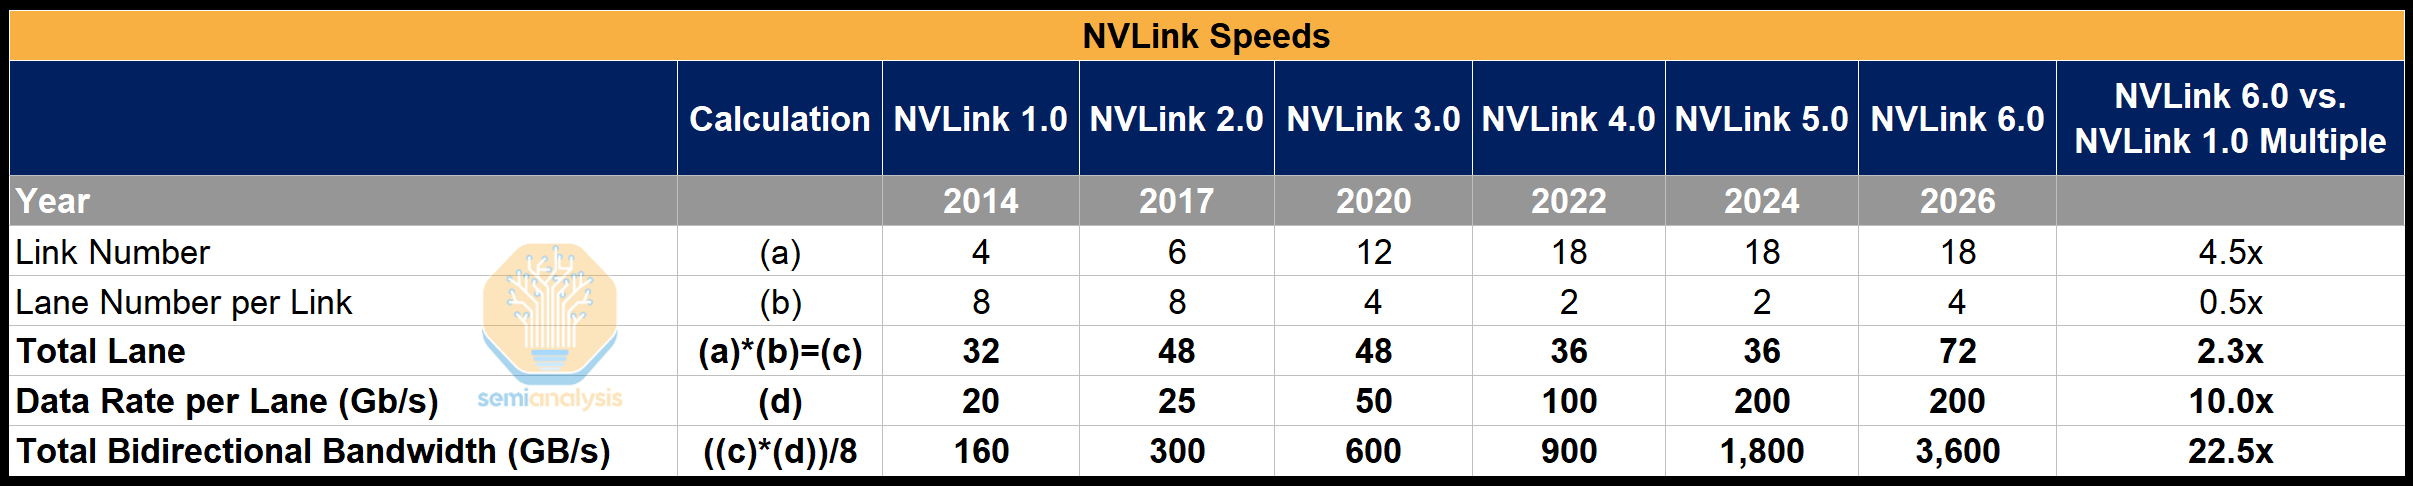
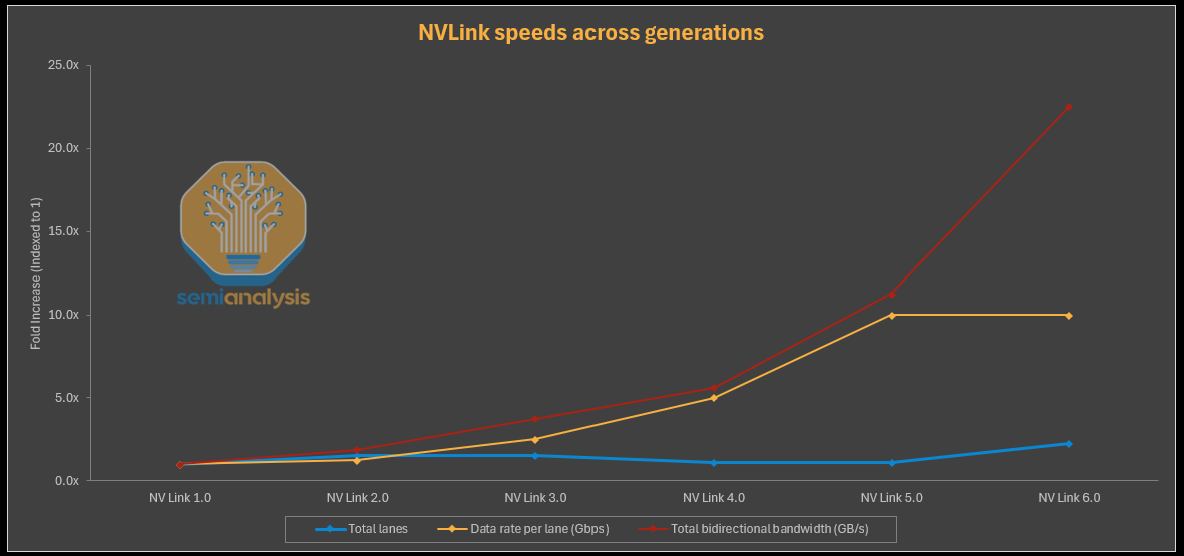
在NVLink协议中,NVLink 5.0的带宽相比NVLink 1.0增长了超过11倍,但这一增长并非源于通道数量的显著增加(仅从32通道增至36通道),核心驱动力是serdes通道速度的10倍提升(从20G增至200G)。然而,在NVLink 6.0中,英伟达预计将维持200G串并转换器速度,这意味着必须通过增加通道数量来实现带宽翻倍——具体而言,将通过双向串并转换器技术,在使用相同数量物理铜缆的情况下,有效翻倍通道数量。除此之外,进一步提升串并转换器速度或突破岸线限制增加通道数量,都将变得越来越困难,最终输出带宽将陷入停滞。
输出带宽的扩展对于行业领先企业至关重要,因为吞吐量是核心差异化优势。对于英伟达而言,其NVLink scale up架构是重要的竞争壁垒——而这一瓶颈可能会让AMD等竞争对手及超大规模数据中心运营商更容易追赶。
解决这一困境的关键(或者说必要的妥协)是:尽可能缩短电IO的传输距离,并在离host ASIC尽可能近的位置,将数据传输卸载至光链路,以实现更高带宽。这也是为何CPO被视为互联技术的“圣杯”——CPO允许光通信在ASIC封装上进行(无论是通过基板还是中介层),电信号仅需通过封装基板传输几毫米,理想情况下甚至可通过更高质量的中介层传输更短距离,而非通过损耗较大的覆铜层压板(CCL)传输数十厘米。
serdes可针对短距离进行优化,所需电路比长距离serdes简单得多,设计难度降低,同时功耗和硅面积也更小。这种简化使更高速度的serdes更容易实现,并延长了serdes的扩展路线图。
尽管如此,我们仍受限于传统带宽模型——带宽密度仍与serdes速度成比例扩展。 要实现更高的带宽密度,宽IO物理层(PHY)是短距离场景下的更优选择,相比serdes接口,其单位功耗的带宽密度更高。当然,宽IO也需要更先进的封装,但在CPO场景中,这一问题并不突出:CPO的封装本就高度先进,因此集成宽IO物理层几乎不会增加额外的封装复杂性。
◆ 宽IO vs 串并转换器
当不再需要驱动电信号传输较长距离时,我们就可以彻底摆脱串行接口,转而使用宽接口——在短距离内提供更高的岸线密度。 以UCIe接口为例:UCIe-A可提供高达约10Tbps/mm的岸线密度,专为先进封装设计(例如通过中介层连接的芯片小间距互联,传输距离小于2毫米)。在一块掩模版尺寸芯片的长边,可实现高达330 Tbits的封装外带宽,双长边则可实现660 Tbits的双向带宽。相比之下,Blackwell架构的封装外带宽仅为23.6Tbps,岸线密度约为0.4Tbps/mm——两者差距显著。
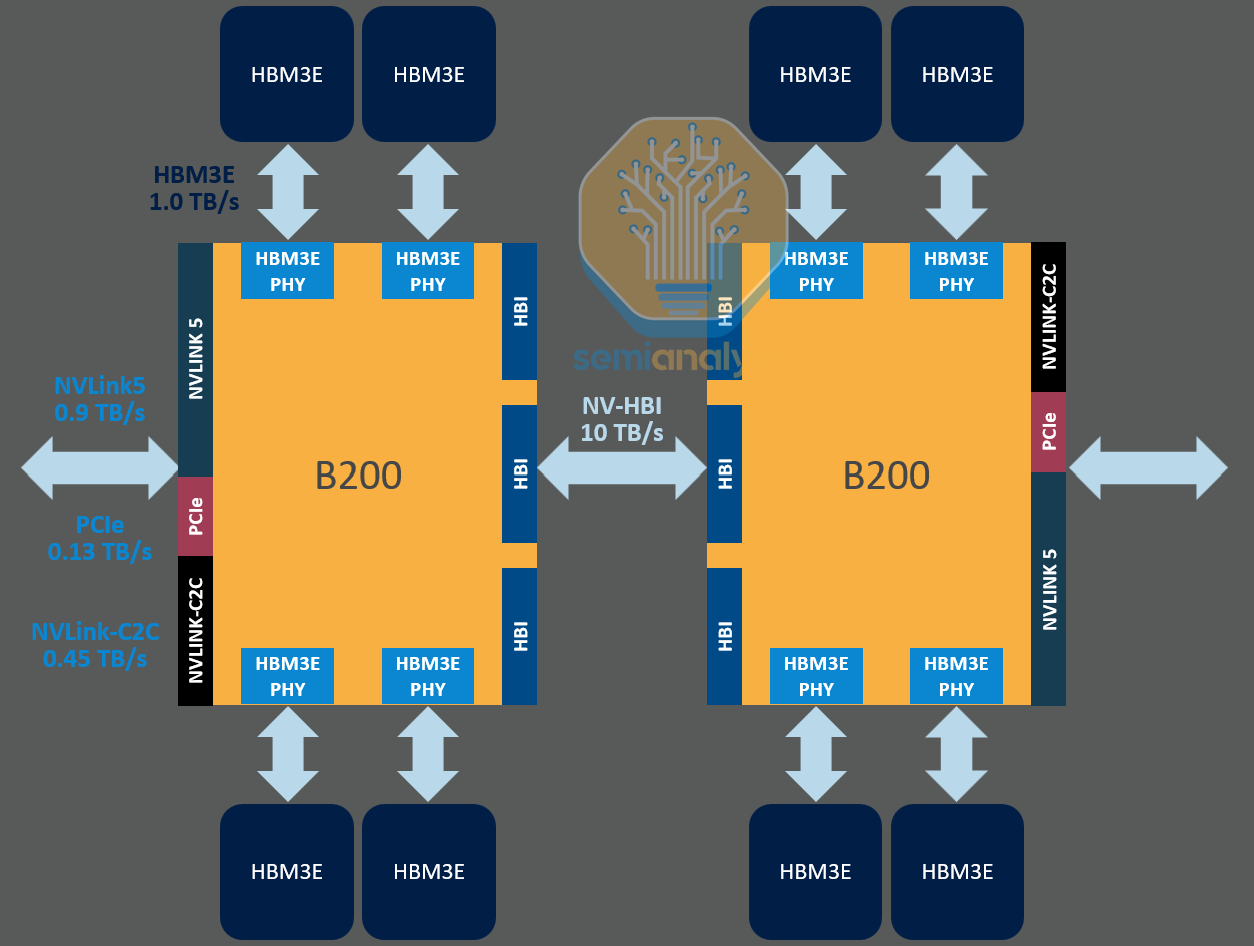
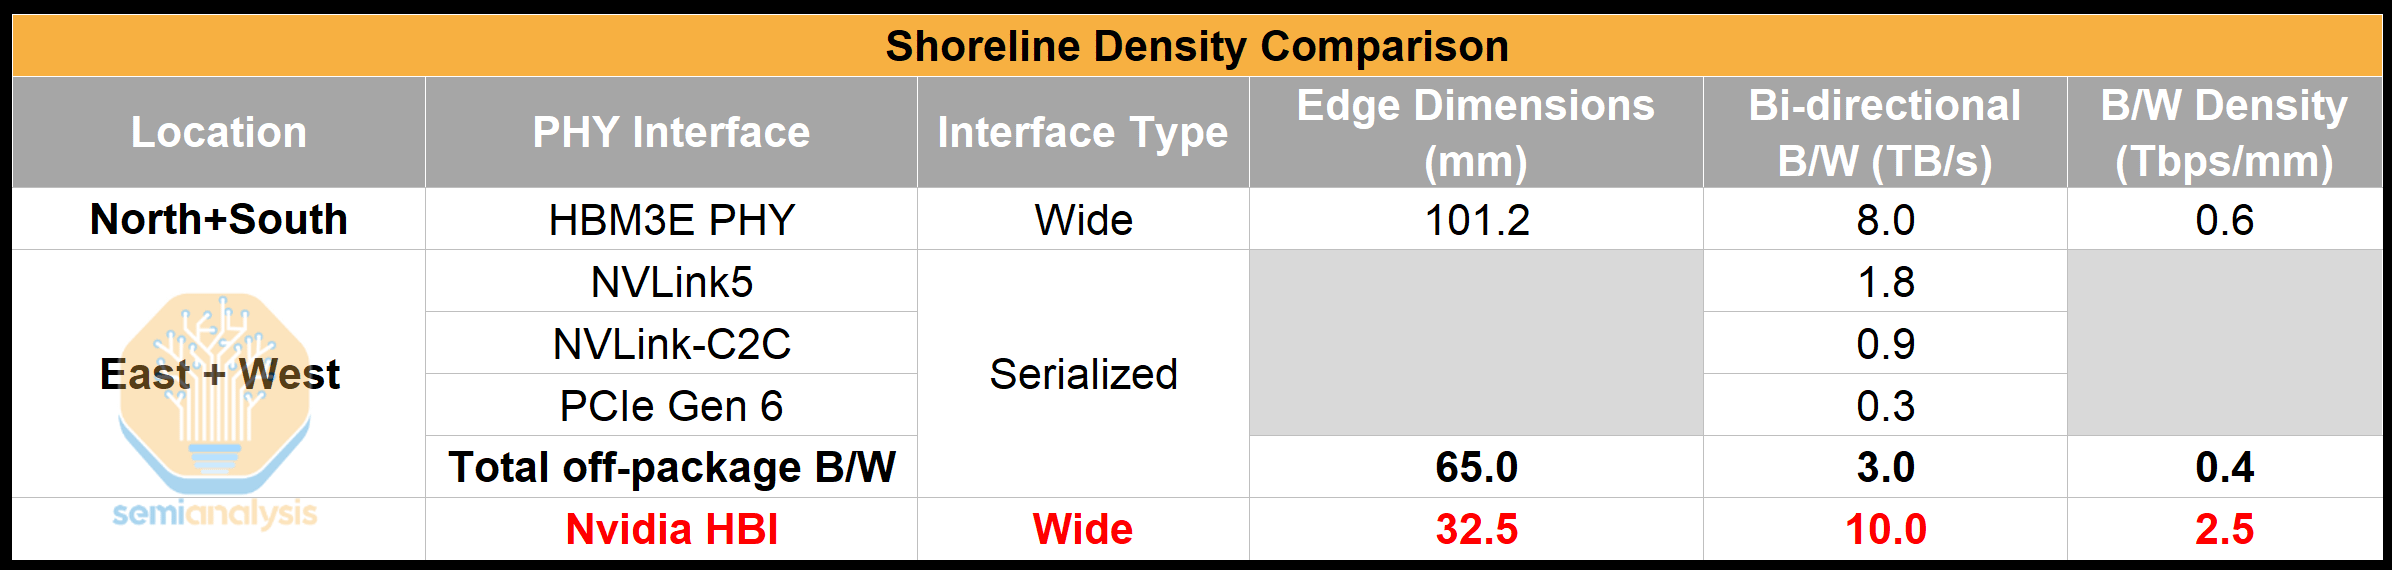
当然,这并非完全公平的对比——这些封装外物理层需要驱动较长距离。而这正是核心要点:有了CPO,传输距离不再是考虑因素,因为电信号无需长距离传输。在10Tbps/mm的带宽密度下,瓶颈不再是电接口,而是链路的其他部分——即光纤可输出的带宽。
要达到这一限制,距离当前现实仍有很长的路要走:光引擎需与host共享中介层,而将CPO集成到中介层本身,比在基板上可靠集成光引擎的路线图更靠后。基板上的物理层性能当然相对较差,UCIe-S的岸线密度约为1.8Tbps/mm,但这仍比我们认为的224G serdes有显著提升。
然而,尽管宽接口具有优势,博通和英伟达仍在其路线图中坚持使用电serdes。主要原因是他们认为串并转换器仍有扩展空间,且需要针对铜缆进行设计(尤其是光学技术的采用速度较慢)。此外,混合式共封装铜缆和共封装光学方案可能会长期存在,这要求他们同时针对两种方案进行优化——这种方式可避免为不同方案进行多次流片。
◆ 链路弹性
链路弹性和可靠性是CPO技术的另一关键驱动因素。在大型AI集群中,链路 downtime是影响集群整体可用性的重要因素——即使是链路可用性和稳定性的微小提升,也能为基础设施投资带来巨大回报。
如今,在一个拥有近百万条可插拔模块链路的大规模AI集群中,每天可能发生数十次链路中断。其中一些是组件故障或硬件质量导致的“硬故障”,但更多是“软故障”——源于可插拔方案固有的复杂性和可变性,故障模式多样,包括但不限于信号完整性问题和波动、连接器和引线键合质量、组件和引脚污染、噪声注入及其他瞬态效应。这些故障与组件故障几乎没有相关性——约80%因链路故障退回的光模块,经检测后“无故障”。
CPO通过以下方式,显著降低了大规模AI网络中高速信号路径的固有复杂性和可变性:
1.大幅减少光接口中的组件数量:光子层面和芯片/封装层面的高度集成,降低了关键高速组件的复杂性,提升了系统级的可靠性和良率;同时减少了电光接口数量,最大限度降低了每个接口的功率损耗。
2.显著改善host ASIC(如交换机)与光引擎之间的主机电接口信号完整性:通过将光引擎封装在一级封装中,并采用定义明确、可预测的设计规则和制造公差,大幅降低了插入损耗、反射和其他非线性损伤。
3.减少交换机上高速信号路径的端口间差异:这种差异会增加DSP信号处理、host和模块均衡、主机和模块固件及链路优化算法的开销和复杂性。所有可插拔模块方案及host serdes,都必须设计为适应这种端口级性能差异——这会导致复杂性和故障点增加。
4. 消除光链路部署中的“人为因素”:CPO交换机或光引擎在出厂时已完全组装并测试合格,无需在现场进行大量光部署操作(这些操作可能导致安装差异、损坏、污染,以及系统与光模块之间的兼容性问题)。